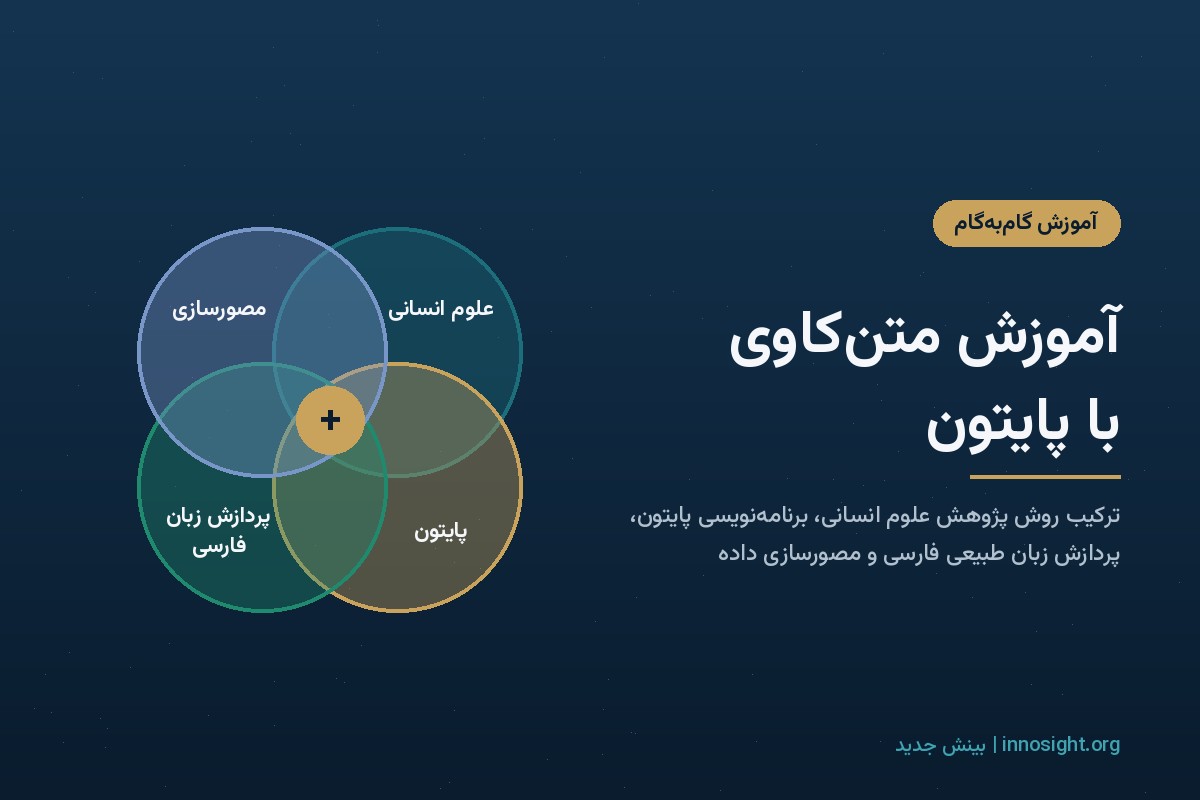
این آموزش متنکاوی با پایتون برای پژوهشگران علوم انسانی، دانشجویان ادبیات، جامعهشناسی، تاریخ و علوم ارتباطات نوشته شده که میخواهند صدها یا هزاران متن فارسی را بهجای خواندن دستیِ تکتک، با کد تحلیل کنند. در این آموزش متنکاوی با پایتون چهار رشته را ترکیب میکنیم: روش پژوهش در علوم انسانی، برنامهنویسی پایتون، پردازش زبان طبیعی فارسی و مصورسازی داده.
بیشتر منابع فارسی این موضوع، صفحهٔ فروش دورهاند و سرفصل میدهند، نه مسیر عملی. اینجا با یک مثال واقعینما از پرسش پژوهشی تا نمودار نهایی پیش میرویم و کد هر مرحله را میبینید.
فهرست مطالب
- آموزش متنکاوی با پایتون: متنکاوی دقیقاً چیست؟
- پیشنیازهای آموزش متنکاوی با پایتون
- رشتهٔ اول، روش پژوهش: از پرسش تا پیکره
- رشتهٔ دوم، پایتون: محیط کار و خواندن داده
- رشتهٔ سوم، پردازش زبان فارسی: پاکسازی و آمادهسازی
- تحلیلهای اصلی: از شمارش تا مدلسازی موضوعی
- رشتهٔ چهارم، مصورسازی: یافته را دیدنی کنید
- نگاه ترکیبی: گردشکار کامل در ۷ مرحله
- مثال کوتاه: مقایسهٔ دو دوره
- اعتبارسنجی نتایج در آموزش متنکاوی با پایتون
- پنج پروژهٔ تمرینی برای آموزش متنکاوی با پایتون
- چکلیست پروژهٔ متنکاوی فارسی
- اشتباهات رایج در آموزش متنکاوی با پایتون
- جمعبندی
- پرسشهای متداول دربارهٔ آموزش متنکاوی با پایتون
آموزش متنکاوی با پایتون: متنکاوی دقیقاً چیست؟
متنکاوی یعنی استخراج الگو، مضمون و دانش از دادهٔ متنی بدون ساختار. شمردن واژههای پرتکرار، یافتن موضوعات پنهان، سنجش لحن مثبت یا منفی و مقایسهٔ گفتمان در دورههای مختلف، همه نمونههایی از متنکاویاند. در علوم انسانی به این رویکرد «خوانش از دور» (distant reading) هم میگویند، در برابر «خوانش نزدیک» که پژوهشگر متن را سطر به سطر میخواند.
نکتهٔ کلیدی این آموزش متنکاوی با پایتون این است که کد جای پژوهشگر را نمیگیرد. الگوریتم الگو را نشان میدهد؛ تفسیر آن الگو کار دانش انسانی است. به همین دلیل این مهارت ذاتاً ترکیبی است و با منطق روش تحقیق آمیخته همخوانی دارد.
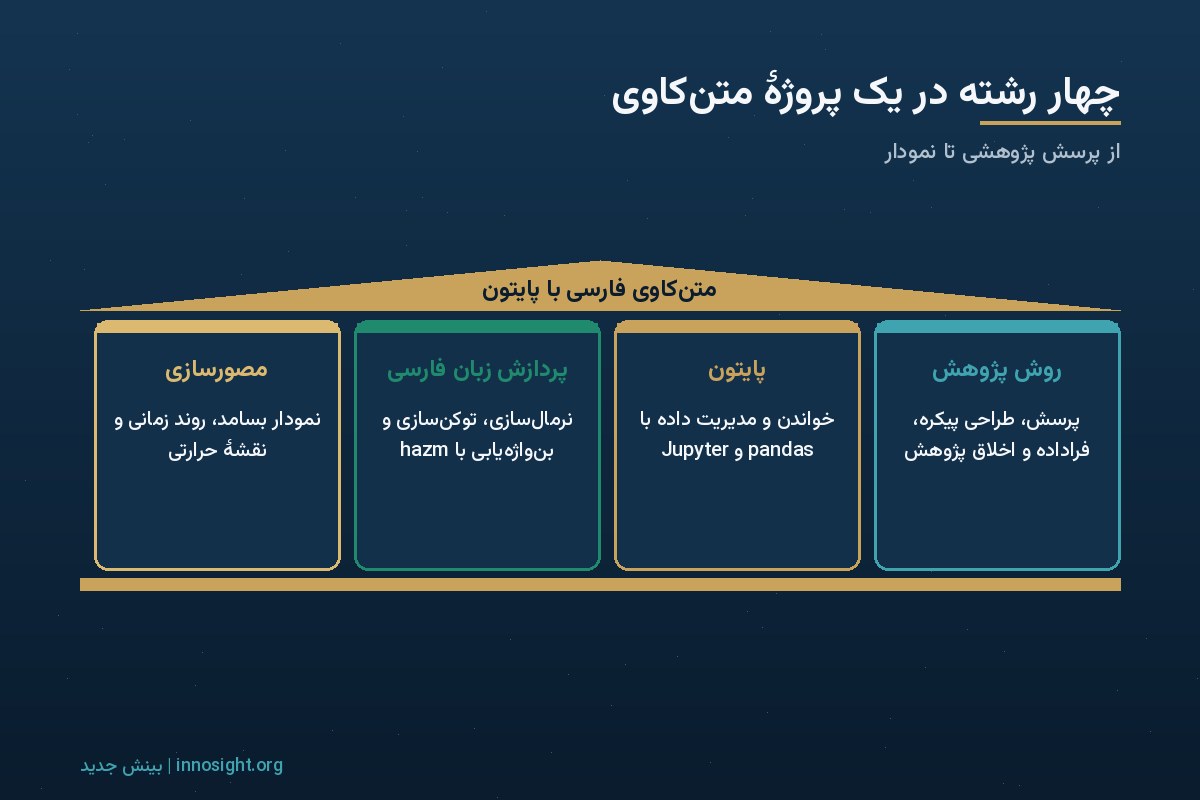
چهار رشتهٔ این آموزش و سهم هرکدام
| رشته | پرسشی که جواب میدهد | ابزار |
|---|---|---|
| روش پژوهش علوم انسانی | چه میپرسیم و چه متنی پاسخ میدهد؟ | طرح پژوهش، نمونهگیری متن |
| برنامهنویسی پایتون | داده را چطور بخوانیم و مدیریت کنیم؟ | pandas، Jupyter |
| پردازش زبان طبیعی فارسی | متن فارسی را چطور قابل تحلیل کنیم؟ | hazm، scikit-learn |
| مصورسازی داده | یافته را چطور نشان دهیم؟ | matplotlib، ابر واژگان |
پیشنیازهای آموزش متنکاوی با پایتون
پیش از شروع، مطمئن شوید این مهارتهای پایه را دارید یا در هفتههای اول یاد میگیرید. این آموزش متنکاوی با پایتون برای افرادی طراحی شده که برنامهنویس حرفهای نیستند.
| مهارت | سطح لازم | زمان تقریبی یادگیری |
|---|---|---|
| مبانی پایتون | متغیر، فهرست، حلقه، تابع | یک تا دو هفته |
| کار با pandas | خواندن CSV، فیلتر، گروهبندی | یک هفته |
| آمار توصیفی | میانگین، توزیع، نسبت | چند روز |
| روش پژوهش کیفی | کدگذاری و تحلیل مضمون | بسته به رشته |
رشتهٔ اول، روش پژوهش: از پرسش تا پیکره
در هر آموزش متنکاوی با پایتون، پروژه با پرسش شروع میشود، نه با کد. مثال این آموزش: «مفهوم محیط زیست در سرمقالههای مطبوعات فارسی در ده سال اخیر چگونه بازنمایی شده است؟» این پرسش سه چیز را مشخص میکند: نوع متن (سرمقاله)، بازهٔ زمانی (ده سال) و مفهوم هدف (محیط زیست).
گام ۱: پیکرهٔ متنی را طراحی کنید
«پیکره» مجموعهٔ متنهایی است که تحلیل میکنید. سه معیار را رعایت کنید: نمایندگی (همهٔ منابع مهم حضور داشته باشند)، توازن (یک منبع یا یک سال بر بقیه غالب نباشد) و فراداده (برای هر متن تاریخ، منبع و نویسنده ثبت شود). بدون فراداده، مقایسهٔ زمانی و منبعی ممکن نیست.
گام ۲: ملاحظات اخلاقی و حقوقی را بررسی کنید
اگر متن از شبکههای اجتماعی یا مصاحبه آمده، اطلاعات هویتی را حذف کنید. برای متون منتشرشده، قوانین حق نشر و شرایط استفادهٔ وبسایت را بخوانید. مستندسازی منبع هر متن، هم اعتبار پژوهش را بالا میبرد و هم تکرارپذیری را ممکن میکند.
رشتهٔ دوم، پایتون: محیط کار و خواندن داده
برای اجرای این آموزش متنکاوی با پایتون، نسخهٔ ۳ پایتون و محیط Jupyter Notebook کافی است. کتابخانههای لازم را نصب کنید:
pip install hazm pandas scikit-learn matplotlib arabic-reshaper python-bidi wordcloudگام ۳: متنها را در یک جدول مرتب کنید
سادهترین ساختار، یک فایل CSV با ستونهای id، date، source و text است. با کتابخانهٔ pandas آن را بخوانید:
import pandas as pd
df = pd.read_csv("editorials.csv", encoding="utf-8")
df["date"] = pd.to_datetime(df["date"])
df["year"] = df["date"].dt.year
print(df.shape, df["source"].value_counts())
همین چند خط نشان میدهد پیکره چند متن دارد و توزیع منابع متوازن است یا نه. اگر یک روزنامه نیمی از متنها را دارد، پیش از تحلیل نمونهگیری را اصلاح کنید.
رشتهٔ سوم، پردازش زبان فارسی: پاکسازی و آمادهسازی
فارسی چالشهای خاص خود را دارد: «ی» و «ک» عربی و فارسی، نیمفاصلههای ناهمگون، پیشوند «می» و پسوندهای جمع. اگر اینها یکسان نشوند، «کتابها» و «كتابها» دو واژهٔ متفاوت شمرده میشوند. به همین دلیل مهمترین مرحلهٔ آموزش متنکاوی با پایتون برای فارسی، پیشپردازش است.
گام ۴: نرمالسازی با hazm در آموزش متنکاوی با پایتون
کتابخانهٔ hazm که متنباز است، ابزارهای پایهٔ پردازش فارسی را فراهم میکند:
from hazm import Normalizer, word_tokenize, Lemmatizer, stopwords_list
normalizer = Normalizer()
lemmatizer = Lemmatizer()
stops = set(stopwords_list())
def preprocess(text):
    text = normalizer.normalize(text)
    tokens = word_tokenize(text)
    tokens = [lemmatizer.lemmatize(t) for t in tokens if t not in stops and len(t) > 1]
    return tokens
df["tokens"] = df["text"].apply(preprocess)
گام ۵: فهرست واژههای ایست را بومی کنید
فهرست آمادهٔ واژههای ایست (مثل «و»، «از»، «این») نقطهٔ شروع است، اما برای هر پیکره باید آن را تکمیل کنید. در سرمقالهها واژههایی مثل «سرمقاله»، «روزنامه» یا نام خود نشریه در همهٔ متنها تکرار میشوند و اطلاعاتی نمیدهند. آنها را به فهرست اضافه کنید.
گام ۶: ریشهیابی یا بنواژهیابی؟
| روش | کار | مثال | کاربرد |
|---|---|---|---|
| ریشهیابی (Stemming) | حذف مکانیکی پسوند | کتابها ← کتاب | سریع، برای شمارش ساده |
| بنواژهیابی (Lemmatization) | بازگرداندن به صورت واژهنامهای | میروم ← رفت#رو | دقیقتر، برای تحلیل معنایی |
تحلیلهای اصلی: از شمارش تا مدلسازی موضوعی
پس از آمادهسازی، نوبت تحلیل است. این بخش از آموزش متنکاوی با پایتون سه تحلیل پرکاربرد در علوم انسانی را پوشش میدهد.
گام ۷: بسامد واژگان و همآیندها
from collections import Counter
freq = Counter(t for toks in df["tokens"] for t in toks)
print(freq.most_common(30))
بسامد ساده، نخستین خروجی هر آموزش متنکاوی با پایتون است و نشان میدهد کدام مفاهیم برجستهاند. برای فهم بافت، «همآیندها» را بررسی کنید: واژههایی که کنار «محیط زیست» میآیند. اگر در یک دوره «بحران» و در دورهٔ دیگر «توسعه» همآیند اصلی باشد، این تغییر گفتمانی است که ارزش خوانش نزدیک دارد.
گام ۸: وزندهی TF-IDF
واژهای که در همهٔ متنها هست، متمایزکننده نیست. TF-IDF به واژههایی وزن بیشتر میدهد که در یک متن پرتکرار و در کل پیکره کمتکرارند:
from sklearn.feature_extraction.text import TfidfVectorizer
docs = df["tokens"].apply(" ".join)
vec = TfidfVectorizer(max_features=3000, ngram_range=(1,2), min_df=3)
X = vec.fit_transform(docs)
گام ۹: مدلسازی موضوعی
مدلسازی موضوعی با الگوریتمهایی مثل LDA یا NMF، موضوعات پنهان پیکره را بهصورت خوشههایی از واژهها نشان میدهد. خروجی فقط فهرست واژه است؛ نامگذاری موضوع با پژوهشگر است. تعداد موضوع را با آزمون چند مقدار و بررسی معناداری انتخاب کنید، نه فقط با یک معیار عددی.
گام ۱۰: تحلیل احساسات متن فارسی
تحلیل احساسات لحن متن را مثبت، منفی یا خنثی برچسب میزند. دو رویکرد اصلی دارید: واژهنامهمحور (شمارش واژههای مثبت و منفی) که شفاف اما ساده است، و مدلمحور (مدلهای زبانی آموزشدیده روی فارسی مثل خانوادهٔ ParsBERT) که دقیقتر است اما به داده و توان پردازشی بیشتری نیاز دارد. برای متون ادبی و طنز، هر دو روش خطا دارند و بازبینی انسانی ضروری است.
رشتهٔ چهارم، مصورسازی: یافته را دیدنی کنید
نمودار خوب نیمی از استدلال پژوهش است و آخرین حلقهٔ این آموزش متنکاوی با پایتون محسوب میشود. در فارسی، matplotlib حروف را جدا و چپبهراست نشان میدهد؛ برای رفع آن از arabic-reshaper و python-bidi استفاده کنید:
import arabic_reshaper
from bidi.algorithm import get_display
import matplotlib.pyplot as plt
fa = lambda s: get_display(arabic_reshaper.reshape(s))
words, counts = zip(*freq.most_common(15))
plt.barh([fa(w) for w in words][::-1], counts[::-1])
plt.title(fa("پرتکرارترین واژهها"))
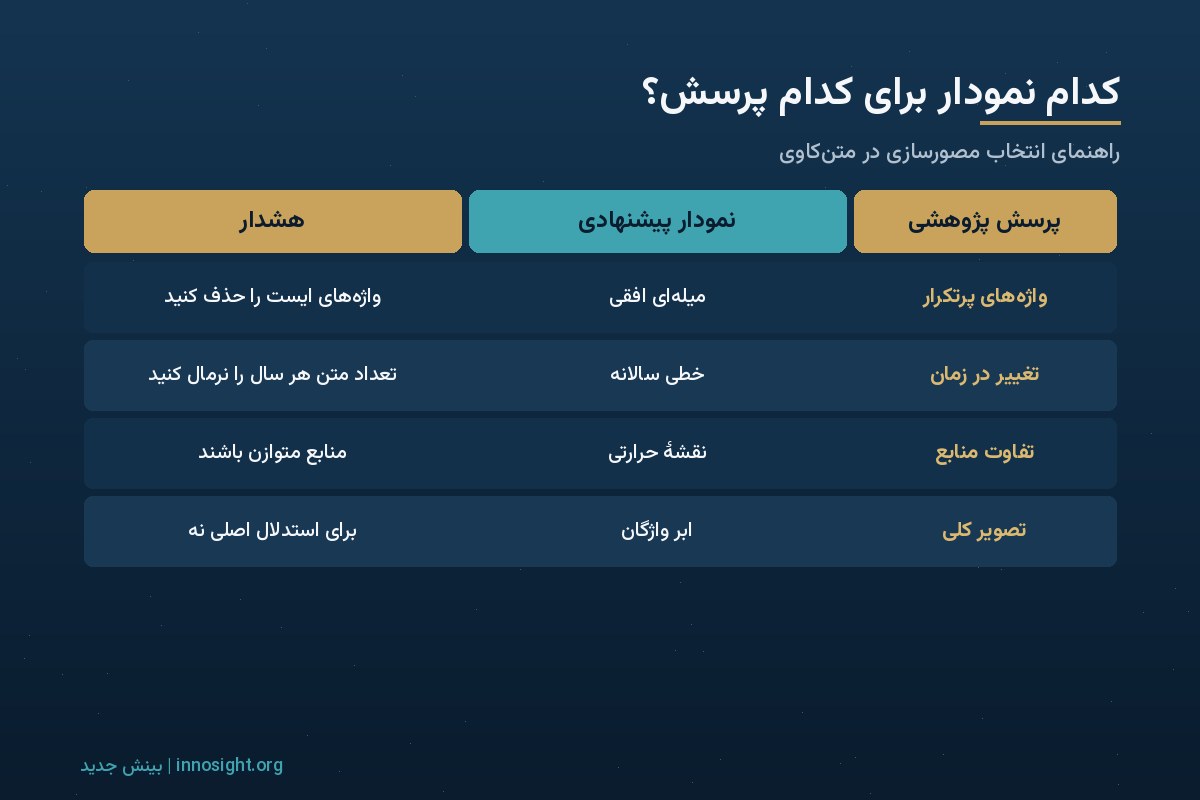
plt.show()گام ۱۱: نمودار مناسب را انتخاب کنید
| پرسش | نمودار پیشنهادی |
|---|---|
| کدام واژهها پرتکرارند؟ | نمودار میلهای افقی |
| یک مفهوم در طول زمان چگونه تغییر کرده؟ | نمودار خطی سالانه |
| منابع مختلف چه تفاوتی دارند؟ | نقشهٔ حرارتی منبع × موضوع |
| تصویر کلی و جذاب برای ارائه | ابر واژگان (با احتیاط) |
ابر واژگان جذاب است اما دقیق نیست؛ اندازهٔ حروف را نمیتوان دقیق مقایسه کرد. برای استدلال اصلی از نمودار میلهای و خطی استفاده کنید. کتاب داستانسرایی با داده اصول طراحی نمودار روشن را خوب توضیح میدهد.
نگاه ترکیبی: گردشکار کامل در ۷ مرحله
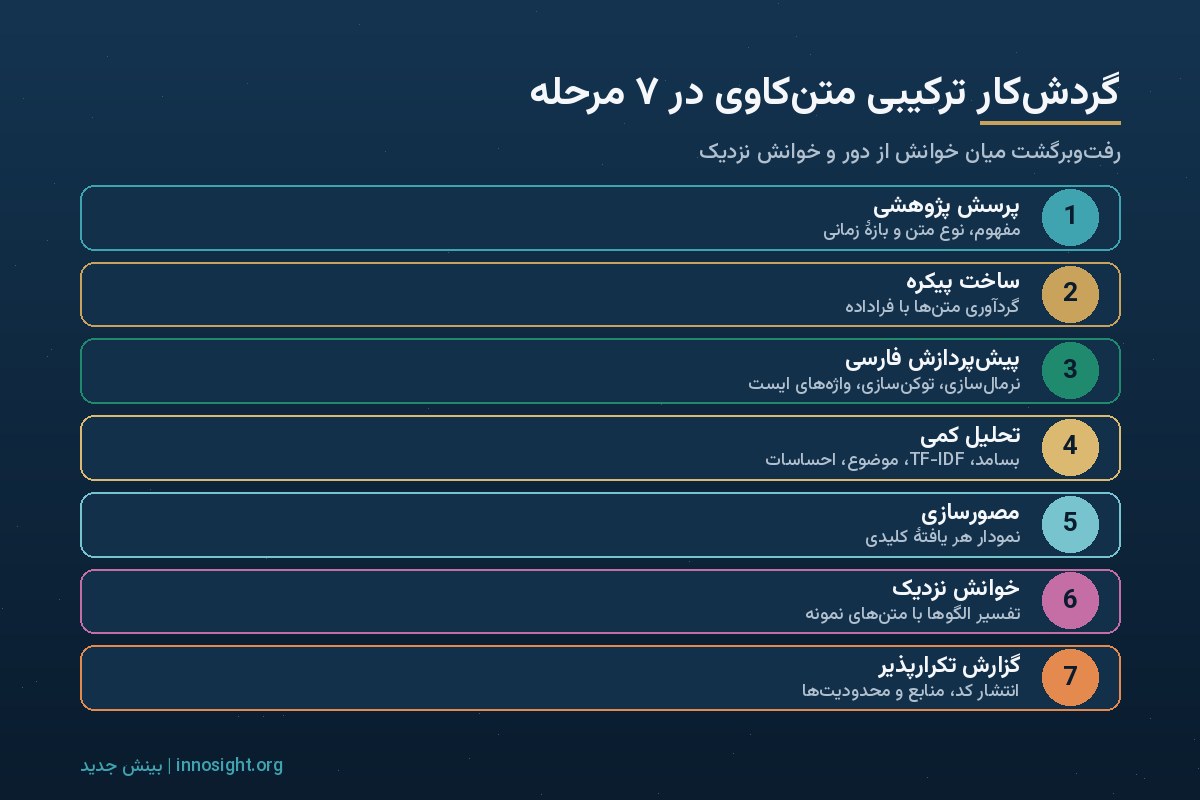
حالا چهار رشته را در یک گردشکار کنار هم میگذاریم. این گردشکار، هستهٔ عملی این آموزش متنکاوی با پایتون است و با هر پیکرهٔ فارسی قابل تکرار است.
گردشکار آموزش متنکاوی با پایتون از پرسش تا گزارش
- پرسش پژوهشی (علوم انسانی): مفهوم، متن و بازهٔ زمانی را مشخص کنید.
- ساخت پیکره (روش پژوهش + پایتون): گردآوری متنها با فراداده در CSV.
- پیشپردازش (پردازش زبان فارسی): نرمالسازی، توکنسازی، حذف واژههای ایست.
- تحلیل کمی (پایتون): بسامد، TF-IDF، مدلسازی موضوعی، تحلیل احساسات.
- مصورسازی: نمودار هر یافتهٔ کلیدی.
- خوانش نزدیک (علوم انسانی): خواندن متنهای نمونه برای تفسیر الگوها.
- گزارش و تکرارپذیری: انتشار کد، فهرست منابع و محدودیتها.
مرحلهٔ ششم همان جایی است که پژوهش علوم انسانی دیجیتال را از گزارش آماری صرف جدا میکند. اگر مدل موضوعی خوشهای از «آب، خشکسالی، سد» نشان داد، باید چند سرمقالهٔ نمونهٔ آن خوشه را بخوانید تا بفهمید لحن غالب انتقادی است یا توجیهی. این رفتوبرگشت میان کمی و کیفی، در مقالهٔ هوش مصنوعی در پژوهش هم بررسی شده است.
مثال کوتاه: مقایسهٔ دو دوره
بیایید آموزش متنکاوی با پایتون را روی یک مثال ببریم. فرض کنید پیکرهٔ شما ۶۰۰ سرمقاله است که نیمی پیش و نیمی پس از یک رویداد مهم زیستمحیطی منتشر شدهاند. با ستون year یا یک ستون period، بسامد واژهها را برای هر دوره جدا حساب کنید. سپس نسبت تغییر هر واژه را بسنجید. واژههایی که بیشترین افزایش را دارند، نامزد تغییر گفتماناند.
این نتیجه هنوز «یافته» نیست، فقط «نشانه» است. نتیجه وقتی معتبر میشود که با خوانش نزدیک، بافت تاریخی و مقایسه با پژوهشهای پیشین پشتیبانی شود. این دقیقاً همان ترکیب رشتههاست که در عنوان این آموزش متنکاوی با پایتون آمده است.
اعتبارسنجی نتایج در آموزش متنکاوی با پایتون
نتیجهٔ الگوریتم زمانی در مقاله یا پایاننامه پذیرفته میشود که اعتبار آن نشان داده شود. سه روش ساده برای این کار وجود دارد.
مقایسه با کدگذاری دستی
یک نمونهٔ تصادفی، مثلاً ۵۰ متن، را دو پژوهشگر بهصورت دستی کدگذاری کنند. سپس برچسبهای دستی را با خروجی مدل مقایسه کنید. اگر توافق پایین بود، پیشپردازش یا مدل را اصلاح کنید. توافق میان دو کدگذار انسانی را هم با ضریب کاپا گزارش کنید.
آزمون پایداری
مدل موضوعی را با چند بذر تصادفی و تعداد موضوع متفاوت اجرا کنید. اگر موضوعات اصلی در همهٔ اجراها تکرار شدند، یافته پایدار است. اگر با هر اجرا تغییر کردند، به آنها تکیه نکنید.
بازخورد متخصص حوزه
نتایج را به یک متخصص موضوع، مثلاً روزنامهنگار محیط زیست یا مورخ مطبوعات، نشان دهید. آیا الگوها برای او معنادار است؟ این گام ساده اغلب خطاهای تفسیری را زود آشکار میکند و یکی از نقاط قوت هر آموزش متنکاوی با پایتون است که بر ترکیب رشتهها تکیه دارد.
پنج پروژهٔ تمرینی برای آموزش متنکاوی با پایتون
بهترین راه یادگیری، اجرای پروژههای کوچک است. این پنج ایده را با دادهٔ عمومی یا پیکرهٔ خودتان اجرا کنید:
- تحلیل بسامد اشعار: مقایسهٔ واژگان پرتکرار دو شاعر کلاسیک با دیوانهای در دسترس عمومی.
- تحلیل احساسات نظرات: برچسبگذاری نظرات کاربران یک فروشگاه اینترنتی کتاب به مثبت و منفی.
- مدلسازی موضوعی چکیدهها: استخراج موضوعات اصلی چکیدهٔ پایاننامههای یک رشته در ده سال.
- تحلیل گفتمان سخنرانیها: مقایسهٔ واژگان کلیدی سخنرانیهای عمومی در دو دورهٔ زمانی.
- شبکهٔ همآیندی: ساخت شبکهای از مفاهیمی که در یک پیکرهٔ خبری کنار هم میآیند.
برای هر پروژه، هفت مرحلهٔ نگاه ترکیبی را دنبال کنید و در پایان یک گزارش دوصفحهای با نمودار و محدودیتها بنویسید. این گزارشها نمونهکار خوبی برای رزومهٔ پژوهشی شما میشوند.
چکلیست پروژهٔ متنکاوی فارسی
- پرسش پژوهشی روشن و قابل پاسخ با متن نوشته شده است.
- پیکره نماینده، متوازن و دارای فراداده است.
- ملاحظات اخلاقی و حق نشر بررسی شده است.
- نرمالسازی فارسی با hazm انجام شده و نتیجه روی چند نمونه بررسی شده است.
- فهرست واژههای ایست برای پیکره بومی شده است.
- تحلیلها با پرسش پژوهشی همراستا هستند، نه صرفاً «چون ابزارش هست».
- نمودارها حروف فارسی را درست نمایش میدهند.
- برای هر الگوی کمی، چند متن نمونه خوانش نزدیک شده است.
- کد و داده (در صورت امکان) برای تکرارپذیری منتشر شده است.
اشتباهات رایج در آموزش متنکاوی با پایتون
- شروع با ابزار بهجای پرسش: رایجترین خطا در آموزش متنکاوی با پایتون همین است؛ اجرای همهٔ الگوریتمها بدون پرسش، نتیجهٔ بیمعنا میدهد.
- نادیده گرفتن نرمالسازی: بدون آن، شمارشها در فارسی غلط است.
- اعتماد بیچونوچرا به تحلیل احساسات: کنایه، طنز و زبان ادبی مدلها را فریب میدهد.
- نامگذاری عجولانهٔ موضوعات: خوشهٔ واژهها را بدون خواندن متنهای نمونه تفسیر نکنید.
- پیکرهٔ نامتوازن: اگر یک منبع غالب باشد، «گفتمان مطبوعات» در واقع گفتمان همان منبع است.
- عدم مستندسازی: بدون ثبت مراحل، داوران و خودتان نمیتوانید نتیجه را بازتولید کنید.
جمعبندی
متنکاوی برای پژوهشگر علوم انسانی یعنی دیدن الگوهایی که در خواندن دستی هزاران متن پنهان میمانند، بیآنکه تفسیر انسانی کنار گذاشته شود. در این آموزش متنکاوی با پایتون دیدید که روش پژوهش پرسش را میسازد، پایتون داده را مدیریت میکند، پردازش زبان فارسی متن را آمادهٔ تحلیل میکند و مصورسازی یافته را قابل فهم میکند. پیشنهاد عملی: با یک پیکرهٔ کوچک ۱۰۰ متنی شروع کنید و همهٔ هفت مرحله را یک بار کامل طی کنید. برای مبانی بیشتر، مقالهٔ علم داده چیست را ببینید.
متنکاوی فارسی را در دورهٔ علم داده برای علوم انسانی، پروژهمحور یاد بگیرید
- ترکیب روش پژوهش، پایتون، پردازش زبان فارسی و مصورسازی در یک مسیر
- تمرین روی پیکرههای واقعی فارسی با کد آماده
- مناسب پایاننامه، مقاله و پروژههای پژوهشی بینرشتهای
مشاهدهٔ دورهٔ علم داده برای علوم انسانی
اگر دربارهٔ انتخاب دوره، زمانبندی یا آموزش سازمانی سؤال دارید، فرم زیر را پر کنید تا همکاران ما با شما تماس بگیرند.
پرسشهای متداول دربارهٔ آموزش متنکاوی با پایتون
متنکاوی چیست و چه تفاوتی با دادهکاوی دارد؟
دادهکاوی معمولاً با دادهٔ ساختاریافته مثل جدول عددی کار میکند، اما متنکاوی دادهٔ متنی بدون ساختار را به ویژگیهای قابل تحلیل تبدیل میکند و سپس الگوها را استخراج میکند. متنکاوی را میتوان شاخهای از دادهکاوی دانست که پیشپردازش زبانی ویژهای دارد.
برای متنکاوی فارسی کدام کتابخانهٔ پایتون بهتر است؟
برای پیشپردازش پایه، کتابخانهٔ hazm پرکاربردترین کتابخانهٔ متنباز فارسی است. برای وزندهی و مدلسازی، scikit-learn و برای مدلهای زبانی پیشرفته، کتابخانههای مبتنی بر ترنسفورمر مناسباند. ترکیب اینها بیشتر نیازهای پژوهشی را پوشش میدهد.
تحلیل احساسات متن فارسی چقدر دقیق است؟
دقت به نوع متن بستگی دارد. برای نظرات کوتاه کاربران دربارهٔ کالا، مدلهای آموزشدیده نتیجهٔ خوبی میدهند. برای متون ادبی، سیاسی یا طنز، دقت پایینتر است و باید بخشی از نتایج را دستی بازبینی کنید.
آیا بدون دانش برنامهنویسی میتوان متنکاوی یاد گرفت؟
بله. برای این آموزش متنکاوی با پایتون فقط مبانی لازم است: متغیر، فهرست، تابع و کار با pandas. بیشتر کدها آمادهاند و شما آنها را با پیکرهٔ خود تطبیق میدهید. در چند هفته تمرین منظم میتوانید نخستین پروژه را اجرا کنید.
نرمافزار تحلیل متن فارسی بهتر است یا پایتون؟
نرمافزارهای تحلیل کیفی برای کدگذاری دستی مناسباند، اما برای پیکرههای بزرگ، تکرارپذیری و تحلیلهای سفارشی، پایتون انعطاف بیشتری دارد و رایگان است. بسیاری از پژوهشگران هر دو را ترکیب میکنند.
هوش مصنوعی مولد چه کمکی به تحلیل متن فارسی میکند؟
مدلهای زبانی بزرگ میتوانند در خلاصهسازی، پیشنهاد برچسب برای موضوعات و کدگذاری اولیه کمک کنند. اما خروجی آنها باید با نمونهٔ دستی اعتبارسنجی شود و استفاده از آنها در روش پژوهش شفاف گزارش شود.
برای پایاننامه چه حجم متنی برای متنکاوی کافی است؟
عدد ثابتی وجود ندارد و به پرسش بستگی دارد. برای تحلیل بسامد، چند صد متن کافی است؛ برای مدلسازی موضوعی معنادار، معمولاً پیکرهٔ بزرگتر لازم است. مهمتر از حجم، نمایندگی و توازن پیکره است.
دیدگاهتان را بنویسید