دوره یادگیری ماشین کاربردی: آمار و ریاضی، پایتون و کاربرد در کسبوکار، کشاورزی و شهر
دوره یادگیری ماشین ترکیبی بینش جدید؛ آمار کاربردی، پایتون و آمادهسازی داده، الگوریتمها با scikit-learn، تفسیرپذیری و اخلاق داده در ۸ ماژول و یک پروژه کامل.
هدف کلی دوره یادگیری ماشین
تربیت متخصصانی که چرخه کامل یک پروژه یادگیری ماشین را، از تعریف مسئله و داده نامرتب تا مدل تفسیرپذیر و گزارش برای تصمیمگیرنده، خودشان اجرا میکنند.
این دوره یادگیری ماشین یک دوره ویژه دانش ترکیبی از آکادمی بینش جدید است که یادگیری ماشین را از مجموعهای از الگوریتمهای جدا به مهارت حل مسئله واقعی با داده تبدیل میکند. در این دوره یادگیری ماشین چهار رشته کنار هم قرار میگیرند: آمار و ریاضی کاربردی، پایتون و مهندسی داده، الگوریتمهای یادگیری ماشین و کاربرد حوزهای در کسبوکار، کشاورزی و شهر همراه با اخلاق داده. نتیجه، توانایی ساختن مدلی است که نهتنها روی داده آزمون دقت خوبی دارد، بلکه به یک تصمیم واقعی کمک میکند.
جستوجوی «دوره یادگیری ماشین» در گوگل بیشتر به سرفصلهای دانشگاهی یا دورههای ویدئویی برنامهنویسی میرسد. دسته اول نظریه قوی دارند اما کمتر به پروژه واقعی میرسند و دسته دوم کد زیاد دارند اما کمتر توضیح میدهند چرا یک مدل انتخاب میشود و نتیجه را چطور باید تفسیر کرد. این صفحه سرفصلها، مخاطبان هدف، پیشنیازها، اهداف آموزشی، دستاوردها و پروژه پایانی دوره را با جزئیات شرح میدهد.
دوره یادگیری ماشین ترکیبی چیست؟
یادگیری ماشین شاخهای از هوش مصنوعی است که در آن بهجای نوشتن قاعدههای صریح، الگوها از داده آموخته میشوند. مدل یادگیری ماشین با دیدن نمونههای گذشته، مثلاً سوابق مشتریانی که خرید را تکرار کردهاند یا نکردهاند، یاد میگیرد درباره نمونههای جدید پیشبینی کند.
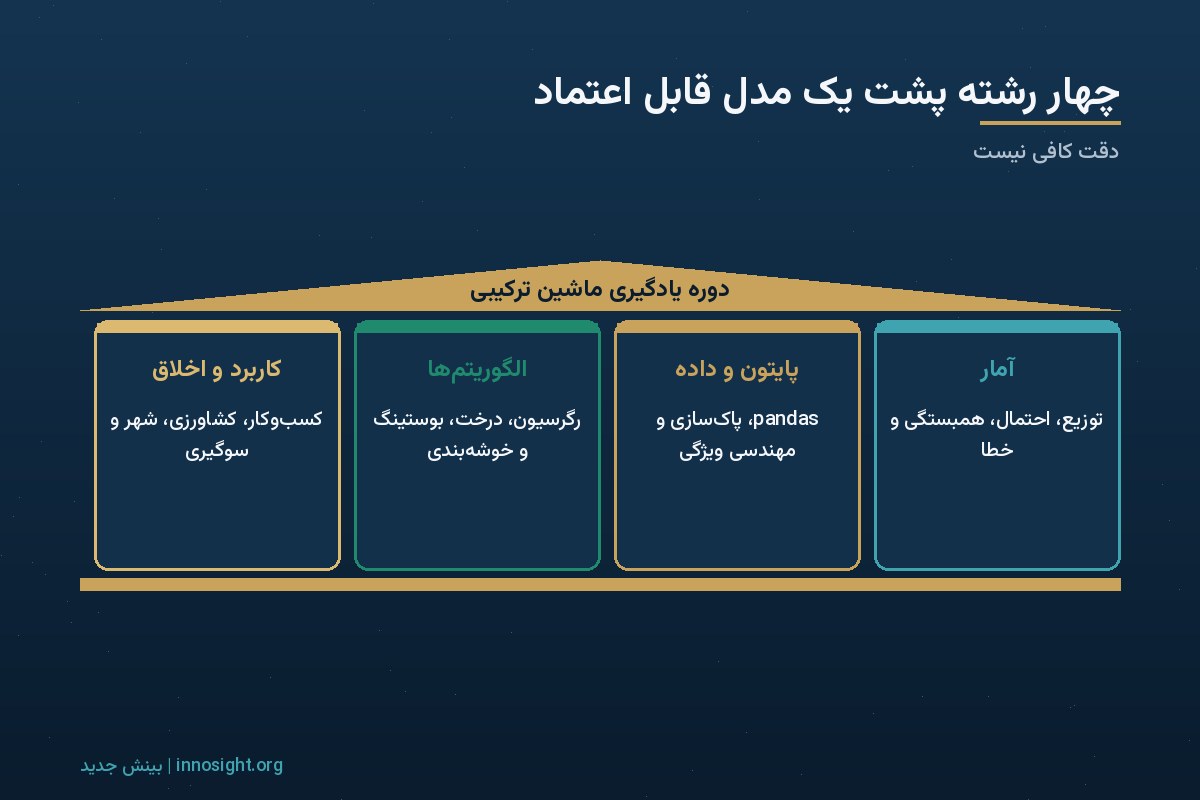
دوره یادگیری ماشین بینش جدید این تعریف را با چهار لایه کامل میکند. لایه اول، آمار و ریاضی: بدون فهم توزیع، همبستگی، احتمال و خطا، انتخاب و ارزیابی مدل حدسی میشود. لایه دوم، پایتون و مهندسی داده: بیشتر زمان یک پروژه واقعی صرف جمعآوری، پاکسازی و آمادهسازی داده میشود. لایه سوم، الگوریتمها: از رگرسیون و درخت تصمیم تا روشهای گروهی و مقدمهای بر شبکههای عصبی. لایه چهارم، کاربرد حوزهای و اخلاق: هر مدل در یک بستر واقعی تصمیم استفاده میشود و خطای آن برای انسانها پیامد دارد.
این دوره یادگیری ماشین مثل سایر دورههای آکادمی مسئلهمحور است و با یک پروژه پایانی به پایان میرسد: یک مسئله واقعی از حوزه کاری شرکتکننده، از تعریف مسئله تا ارائه مدل و گزارش.
یادگیری ماشین، هوش مصنوعی و علم داده چه تفاوتی دارند؟
هوش مصنوعی چتر بزرگتر است و هر سیستمی را که رفتار هوشمند نشان دهد، در بر میگیرد. یادگیری ماشین یکی از روشهای اصلی ساختن این سیستمهاست. علم داده دامنه وسیعتری از تحلیل، آمار، مصورسازی و ارتباط یافتهها را پوشش میدهد و یادگیری ماشین یکی از ابزارهای آن است. در دورههای آکادمی، از جمله همین دوره، این مرزها همیشه با مثال روشن میشود.
چرا یک دوره یادگیری ماشین ترکیبی؟
در بررسی پنج نتیجه اول گوگل برای این عبارت، از سرفصل درس دانشگاهی تا دورههای برنامهنویسی، سه شکاف آشکار دیده میشود:
- فاصله نظریه و پروژه: سرفصلهای دانشگاهی الگوریتمها را عمیق آموزش میدهند، اما کمتر شرکتکننده را به یک پروژه کامل با داده نامرتب واقعی میرسانند.
- کد بدون تفسیر: دورههای برنامهنویسی کد آماده زیادی دارند، اما کمتر توضیح میدهند چرا یک شاخص ارزیابی انتخاب شد یا مدل چه زمانی نباید استفاده شود.
- نبود بستر حوزهای و اخلاق: نمونهها معمولاً مجموعه دادههای آموزشی مشهورند و درباره سوگیری، شفافیت و پیامد خطا در تصمیم واقعی بحث نمیشود.
تفاوت این دوره با آموزش یادگیری ماشین رایج
| معیار | آموزش یادگیری ماشین رایج | دوره یادگیری ماشین ترکیبی |
|---|---|---|
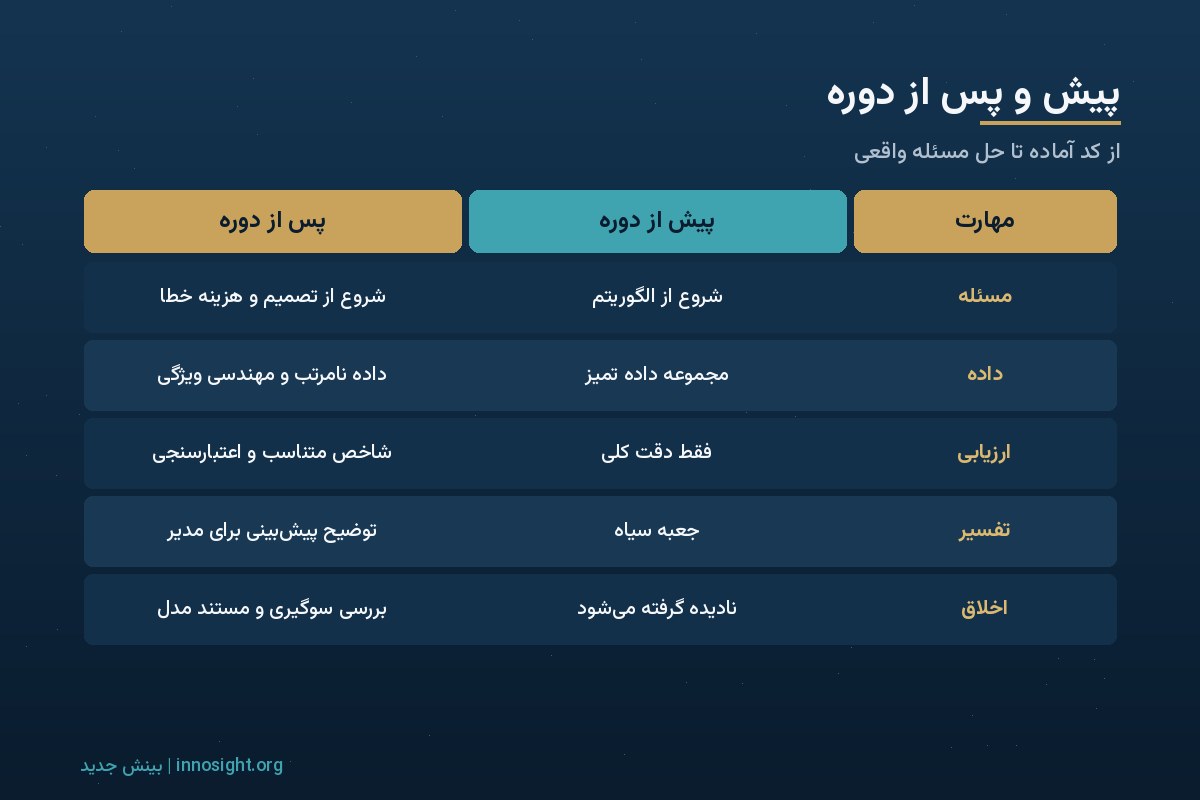
| محور اصلی | فهرست الگوریتمها | چرخه کامل حل مسئله با داده |
| آمار و ریاضی | یا خیلی سنگین یا حذفشده | به اندازه نیاز و همراه با شهود |
| داده | مجموعه داده تمیز آموزشی | داده نامرتب، پاکسازی و مهندسی ویژگی |
| ارزیابی | دقت روی داده آزمون | شاخص متناسب با هزینه خطا و تفسیرپذیری |
| کاربرد | مثالهای عمومی | کسبوکار، کشاورزی، شهر و حوزه شرکتکننده |
| اخلاق | ندارد | سوگیری، حریم خصوصی و شفافیت |
| خروجی | تمرینهای جدا | پروژه پایانی کامل با گزارش و ارائه |
چهار رشته در دوره یادگیری ماشین
هر رشته در این دوره نقش مشخصی دارد و در بیشتر ماژولها دستکم دو رشته با هم تمرین میشوند.
رشته اول: آمار و ریاضی کاربردی
این رشته پایه فکری دوره است: آمار توصیفی، توزیعها، احتمال، همبستگی و علیت، نمونهگیری و خطا، و از ریاضی، بردار و ماتریس و مفهوم گرادیان در حد شهودی. هدف حفظ کردن فرمول نیست، بلکه فهمیدن این است که مدل در پشت صحنه چه میکند و چرا گاهی نتیجهای فریبنده میدهد.
رشته دوم: پایتون و مهندسی داده
در این رشته کار با پایتون، کتابخانههای pandas و NumPy، خواندن داده از منابع مختلف، پاکسازی، مدیریت داده گمشده، مهندسی ویژگی و مصورسازی تمرین میشود. اگر تجربه کمی با پایتون دارید، آموزش تحلیل داده و اتوماسیون با پایتون نقطه شروع خوبی است و دوره برنامهنویسی و اتوماسیون تحلیلهای ترکیبی این مهارتها را عمیقتر میکند.
رشته سوم: الگوریتمهای یادگیری ماشین
یادگیری نظارتشده شامل رگرسیون خطی و لجستیک، درخت تصمیم، جنگل تصادفی و گرادیان بوستینگ، یادگیری بدون نظارت شامل خوشهبندی و کاهش ابعاد، و مقدمهای بر شبکههای عصبی و یادگیری عمیق در این رشته قرار دارند. ابزار اصلی پیادهسازی کتابخانه scikit-learn است که مستندات آموزشی کامل و نمونههای فراوانی دارد.
رشته چهارم: کاربرد حوزهای و اخلاق داده
مدل خوب در خلأ ساخته نمیشود. در این رشته سه حوزه نمونه بررسی میشود: کسبوکار، مثل پیشبینی ریزش مشتری و تقاضا؛ کشاورزی، مثل تشخیص بیماری گیاه که در آموزش تشخیص بیماری گیاهان با هوش مصنوعی شرح داده شده؛ و شهر، مثل تحلیل الگوهای فضایی. در کنار آن، سوگیری داده، حریم خصوصی و تفسیرپذیری مدل آموزش داده میشود.
مخاطبان هدف دوره یادگیری ماشین
این دوره برای کسانی طراحی شده که با داده سروکار دارند و میخواهند از تحلیل توصیفی به پیشبینی و تصمیمسازی برسند:
تحلیلگران داده و کسبوکار
که با اکسل یا SQL کار میکنند و میخواهند مدلهای پیشبینی بسازند.
برنامهنویسان و مهندسان نرمافزار
که میخواهند یادگیری ماشین را به محصول خود اضافه کنند.
پژوهشگران و دانشجویان تحصیلات تکمیلی
در رشتههای مهندسی، کشاورزی، شهرسازی، اقتصاد و علوم اجتماعی که داده پژوهشی دارند.
متخصصان حوزهای
مثل کارشناسان کشاورزی، منابع انسانی یا بازاریابی که میخواهند با تیم داده زبان مشترک داشته باشند.
مدیران محصول و مدیران فنی
که درباره پروژههای هوش مصنوعی تصمیم میگیرند.
تغییردهندگان مسیر شغلی
که میخواهند وارد حوزه علم داده و یادگیری ماشین شوند.
پیشنیازهای دوره یادگیری ماشین و آمادگی پیش از شروع
پیشنیاز یادگیری ماشین یکی از پرسشهای پرتکرار جستوجوست. پاسخ کوتاه این است که به ریاضی پیشرفته نیاز ندارید، اما به چند پایه نیاز دارید:
- پایتون مقدماتی: متغیر، حلقه، شرط، تابع و کار با فهرست و دیکشنری. اگر اینها را نمیدانید، پیش از دوره چند هفته تمرین کنید.
- ریاضیات دبیرستانی: تابع، نمودار، توان و لگاریتم. مفاهیم جبر خطی و حسابان مورد نیاز در خود دوره به زبان شهودی مرور میشوند.
- آمار مقدماتی: میانگین، میانه، انحراف معیار و درصد. بقیه در ماژول اول آموزش داده میشود.
- یک رایانه و دسترسی به اینترنت: برای کار با Jupyter یا Google Colab.
- یک مسئله یا داده: اگر دادهای از کار یا پژوهش خود دارید، آن را برای پروژه پایانی در نظر بگیرید. در غیر این صورت مجموعه داده نمونه در اختیارتان قرار میگیرد.
برای مرور مقدماتی پیش از دوره، دوره فشرده یادگیری ماشین گوگل منبع رایگان مناسبی است.
اهداف آموزشی دوره یادگیری ماشین
اهداف آموزشی این دوره به شکل تواناییهای قابل مشاهده تعریف شدهاند. در پایان دوره باید بتوانید:
- یک مسئله کسبوکار یا پژوهشی را به مسئله یادگیری ماشین، از نوع طبقهبندی، رگرسیون یا خوشهبندی، تبدیل کنید.
- داده خام را با پایتون بخوانید، پاکسازی و برای مدلسازی آماده کنید.
- با تحلیل اکتشافی و مصورسازی، الگوها و مشکلات داده را پیدا کنید.
- مدلهای پایه و پیشرفته را با scikit-learn آموزش دهید و مقایسه کنید.
- شاخص ارزیابی مناسب را با توجه به هزینه خطا انتخاب کنید و از بیشبرازش جلوگیری کنید.
- تصمیم مدل را با روشهای تفسیرپذیری برای مخاطب غیرفنی توضیح دهید.
- سوگیری احتمالی داده و مدل را بررسی و مستند کنید.
- پروژه کامل یادگیری ماشین را با گزارش و ارائه روشن تحویل دهید.
سرفصلهای دوره یادگیری ماشین
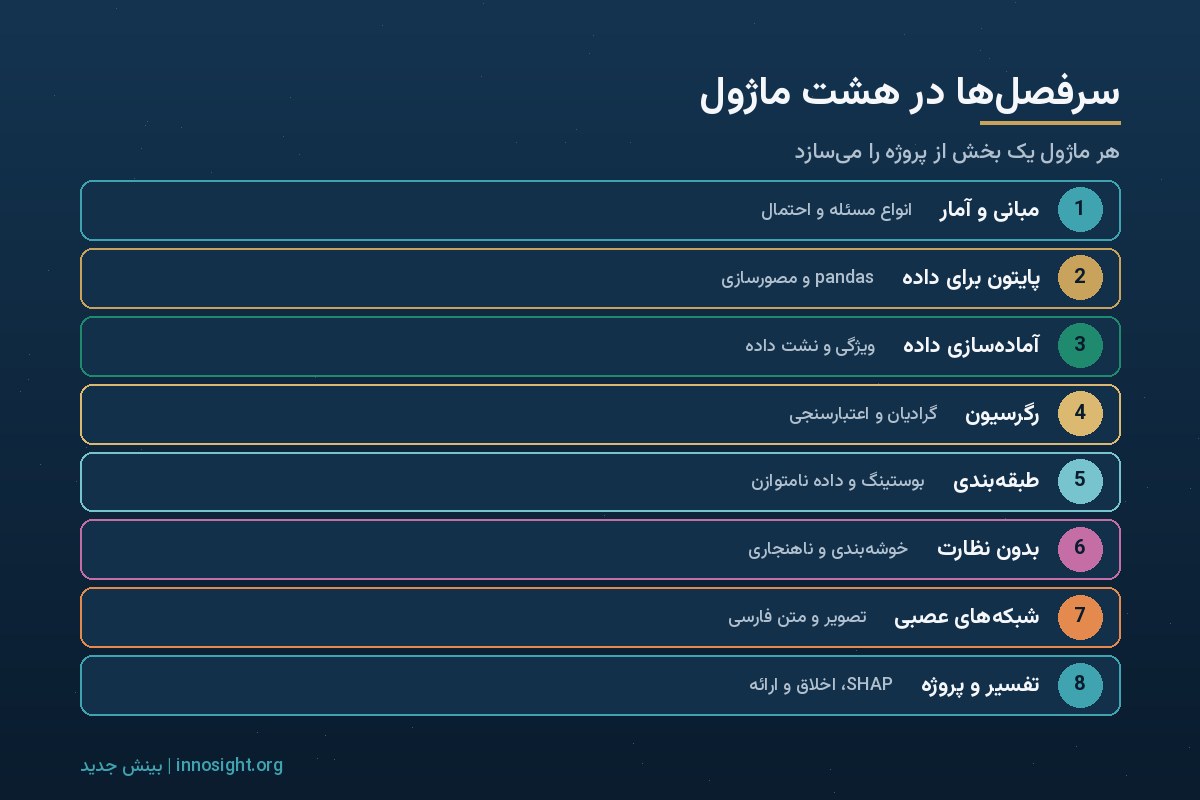
سرفصلهای دوره یادگیری ماشین در هشت ماژول تنظیم شدهاند. هر ماژول سه جلسه، یک تمرین کدنویسی و یک بخش از پروژه پایانی دارد. روی هر ماژول دوره یادگیری ماشین بزنید تا جلسههای آن را ببینید.
۱ماژول ۱: مبانی یادگیری ماشین و آمار کاربردی
این ماژول زبان مشترک دوره را میسازد و پایه آماری لازم را مرور میکند.
۳ جلسه
یادگیری ماشین چیست؛ انواع مسئله و چرخه پروژه
آمار توصیفی، توزیعها و احتمال
همبستگی، علیت و خطاهای رایج تفسیر
۲ماژول ۲: پایتون برای داده
این ماژول ابزار کار روزانه را آماده میکند.
۳ جلسه
محیط Jupyter و Colab، NumPy و pandas
خواندن، ادغام و تبدیل داده
مصورسازی با Matplotlib و Seaborn
۳ماژول ۳: آمادهسازی داده و مهندسی ویژگی
در پروژههای واقعی، کیفیت داده بیش از انتخاب الگوریتم بر نتیجه اثر دارد.
۳ جلسه
داده گمشده، داده پرت و تحلیل اکتشافی
کدگذاری متغیرهای دستهای و مقیاسبندی
مهندسی ویژگی و جلوگیری از نشت داده
۴ماژول ۴: یادگیری نظارتشده؛ رگرسیون
این ماژول پیشبینی مقادیر عددی مثل تقاضا، قیمت یا عملکرد محصول را آموزش میدهد.
۳ جلسه
رگرسیون خطی و مفهوم تابع هزینه و گرادیان
منظمسازی و انتخاب ویژگی
شاخصهای ارزیابی رگرسیون و اعتبارسنجی متقابل
۵ماژول ۵: یادگیری نظارتشده؛ طبقهبندی
این ماژول پیشبینی دستهها مثل ریزش یا ماندن مشتری را پوشش میدهد.
۳ جلسه
رگرسیون لجستیک و درخت تصمیم
جنگل تصادفی و گرادیان بوستینگ
ماتریس درهمریختگی، دقت، بازیابی و داده نامتوازن
۶ماژول ۶: یادگیری بدون نظارت
وقتی برچسب نداریم، هنوز میتوانیم ساختار داده را کشف کنیم.
۳ جلسه
خوشهبندی و بخشبندی مشتری
کاهش ابعاد و مصورسازی داده چندبعدی
تشخیص ناهنجاری
۷ماژول ۷: شبکههای عصبی و داده متنی و تصویری
این ماژول دری به یادگیری عمیق باز میکند، بدون اینکه دوره را به یک دوره تخصصی یادگیری عمیق تبدیل کند.
۳ جلسه
شبکه عصبی ساده و مفهوم یادگیری عمیق
مقدمه طبقهبندی تصویر با مدلهای ازپیشآموخته
مقدمه پردازش متن فارسی
۸ماژول ۸: تفسیرپذیری، اخلاق و پروژه پایانی
آخرین ماژول مدل را به تصمیم و گزارش قابل اعتماد تبدیل میکند.
۳ جلسه
اهمیت ویژگی و توضیح پیشبینیها
سوگیری، حریم خصوصی و مستندسازی مدل
ارائه پروژه پایانی و دریافت بازخورد
نقشه راه دوره یادگیری ماشین در یک نگاه
هشت ماژول و ۲۴ جلسه دوره یادگیری ماشین در سه مرحله؛ از مبانی تا پروژه پایانی واقعی.
مبانی و پایهها
کاربرد و تمرین مهارتها
یکپارچهسازی و پروژه پایانی
حضور چهار محور دانشی در ۸ ماژول دوره یادگیری ماشین
تقسیم ۲۴ جلسه در سه مرحله
- مرحله ۱: مبانی۹ جلسه
- مرحله ۲: کاربرد۹ جلسه
- مرحله ۳: پروژه۶ جلسه
نقشه راه هفتگی دوره یادگیری ماشین
جدول زیر ترتیب پیشنهادی ماژولها و خروجی هر مرحله را نشان میدهد. زمانبندی نهایی و تعداد جلسات هفتگی هنگام اعلام دوره در تقویم آموزشی مشخص میشود.
| مرحله | ماژول | خروجی برای پروژه پایانی |
|---|---|---|
| هفته ۱ و ۲ | مبانی و آمار | تعریف مسئله و شاخص موفقیت |
| هفته ۳ و ۴ | پایتون برای داده | بارگذاری داده و گزارش توصیفی |
| هفته ۵ و ۶ | آمادهسازی داده | داده پاک و ویژگیهای جدید |
| هفته ۷ و ۸ | رگرسیون | مدل پایه و اعتبارسنجی |
| هفته ۹ و ۱۰ | طبقهبندی | مقایسه چند مدل |
| هفته ۱۱ | یادگیری بدون نظارت | بخشبندی یا تحلیل ناهنجاری |
| هفته ۱۲ و ۱۳ | شبکههای عصبی | آزمایش یک مدل پیشرفتهتر |
| هفته ۱۴ تا ۱۶ | تفسیرپذیری و پروژه | گزارش، مستند مدل و ارائه |
ابزارها و نرمافزارهای دوره یادگیری ماشین
همه ابزارهای این دوره متنباز یا رایگاناند:
| ابزار | کاربرد در دوره | ماژول |
|---|---|---|
| Python و Jupyter یا Google Colab | محیط کدنویسی و گزارش | همه |
| pandas و NumPy | کار با داده جدولی | ۲ و ۳ |
| Matplotlib و Seaborn | مصورسازی | ۲ و ۳ |
| scikit-learn | مدلسازی، ارزیابی و خط لوله | ۴ تا ۶ |
| Keras یا PyTorch | مقدمه شبکههای عصبی | ۷ |
| SHAP | تفسیرپذیری پیشبینیها | ۸ |
| Kaggle | مجموعه داده و تمرین | همه |
سکوی Kaggle مجموعه دادههای متنوع و نوتبوکهای آموزشی زیادی دارد و برای تمرین بیشتر پس از دوره هم مفید است.
نمونه کد: خط لوله ساده طبقهبندی
from sklearn.model_selection import train_test_split, cross_val_score
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.ensemble import RandomForestClassifier

X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, stratify=y, random_state=42)

model = make_pipeline(StandardScaler(), RandomForestClassifier(random_state=42))
scores = cross_val_score(model, X_train, y_train, cv=5, scoring="recall")
print("میانگین بازیابی:", scores.mean())
در این نمونه، شاخص «بازیابی» عمداً انتخاب شده است؛ اگر از دست دادن یک مشتری در حال ریزش پرهزینهتر از هشدار اشتباه باشد، بازیابی از دقت کلی مهمتر است. انتخاب شاخص، یک تصمیم کسبوکار است، نه فقط یک تصمیم فنی.
نگاه ترکیبی: پروژه پایانی دوره
قلب این دوره یادگیری ماشین پروژه پایانی است. شرکتکننده از ماژول اول یک مسئله انتخاب میکند و در هر ماژول بخشی از پاسخ را میسازد.
نمونه: پیشبینی ریزش مشتری در یک فروشگاه اینترنتی
فرض کنید پروژه شما پیشبینی مشتریانی است که احتمالاً دیگر خرید نمیکنند. دادهها و اعداد این نمونه فرضیاند:
- آمار: تحلیل توصیفی نشان میدهد فاصله زمانی آخرین خرید و تعداد تماس با پشتیبانی با ریزش رابطه دارد، اما همبستگی را با علیت اشتباه نمیگیریم.
- پایتون و داده: سوابق سفارش، پشتیبانی و بازدید ادغام و ویژگیهایی مثل تازگی، دفعات و مبلغ خرید ساخته میشود.
- الگوریتمها: رگرسیون لجستیک بهعنوان مدل پایه با جنگل تصادفی و گرادیان بوستینگ مقایسه میشود.
- کاربرد حوزهای: با تیم بازاریابی تعیین میشود که خطای از دست دادن مشتری پرهزینهتر است، پس بازیابی شاخص اصلی است.
- اخلاق و تفسیر: ویژگیهای حساس حذف و دلایل پیشبینی برای تیم بازاریابی توضیح داده میشود.
هیچیک از چهار رشته بهتنهایی کافی نبود. آمار از نتیجهگیری عجولانه جلوگیری کرد، مهندسی داده ویژگیهای مفید را ساخت، الگوریتم پیشبینی را بهتر کرد و دانش حوزهای تعیین کرد چه چیزی واقعاً موفقیت است.
خروجیهای تحویلی پروژه پایانی
- بیانیه مسئله، شاخص موفقیت و هزینه انواع خطا
- نوتبوک تمیز با آمادهسازی داده و تحلیل اکتشافی
- مقایسه دستکم سه مدل با اعتبارسنجی متقابل
- تفسیر مدل و بررسی سوگیری
- گزارش یکصفحهای برای مخاطب غیرفنی و ارائه نهایی
دستاوردهای پس از دوره یادگیری ماشین
انتظار میرود پس از پایان دوره یادگیری ماشین به این نتایج برسید:
چرخه کامل پروژه
از تعریف مسئله تا ارائه مدل را خودتان اجرا میکنید.
مهارت آمادهسازی داده
با داده نامرتب واقعی بدون سردرگمی کار میکنید.
انتخاب آگاهانه مدل
میدانید کدام مدل برای کدام مسئله مناسب است و چرا.
ارزیابی درست
شاخص متناسب با هزینه خطا را انتخاب میکنید و بیشبرازش را تشخیص میدهید.
توضیح برای غیرمتخصص
نتیجه مدل را به زبان تصمیم برای مدیر یا مشتری بیان میکنید.
نمونه کار
یک پروژه کامل در مخزن کد خود برای رزومه و مصاحبه شغلی دارید.
سه تمرین نمونه از جلسههای دوره
برای اینکه تصویر روشنتری از کلاس داشته باشید، سه تمرین نمونه را مرور میکنیم.
تمرین شکار نشت داده
یک نوتبوک آماده با مدلی که دقت بسیار بالایی دارد، در اختیار شرکتکنندگان قرار میگیرد. وظیفه آنها پیدا کردن دلیل این دقت غیرواقعی است: ویژگیای که اطلاعات آینده را به مدل لو میدهد. این تمرین نشان میدهد چرا دقت بالا همیشه خبر خوب نیست.
تمرین انتخاب شاخص با هزینه خطا
برای سه سناریوی متفاوت، یعنی تشخیص بیماری گیاه، تأیید وام و پیشنهاد محصول، شرکتکنندگان باید تعیین کنند کدام نوع خطا پرهزینهتر است و بر این اساس، شاخص اصلی ارزیابی را انتخاب و از انتخاب خود دفاع کنند.
تمرین توضیح مدل در یک دقیقه
هر شرکتکننده باید نتیجه مدل خود را در یک دقیقه و بدون هیچ واژه فنی برای یک مدیر فرضی توضیح دهد. گروه بازخورد میدهد که آیا مدیر میتواند بر پایه این توضیح تصمیم بگیرد. این مهارت در عمل بهاندازه خود مدلسازی مهم است.
اشتباهات رایج در پروژههای یادگیری ماشین
بیشتر پروژههای ناموفق یادگیری ماشین نه به دلیل الگوریتم ضعیف، بلکه به دلیل چند خطای تکراری شکست میخورند. شناختن آنها پیش از شروع دوره یادگیری ماشین به شما کمک میکند تمرینها را با دقت بیشتری انجام دهید:
- شروع از الگوریتم بهجای مسئله: انتخاب یک مدل پیچیده پیش از روشن شدن تصمیمی که قرار است بهتر شود، معمولاً به مدلی دقیق اما بیاستفاده میرسد.
- نشت داده: استفاده از ویژگیهایی که در لحظه پیشبینی در دسترس نیستند، دقت را روی کاغذ بالا و در عمل صفر میکند.
- اعتماد به دقت کلی در داده نامتوازن: اگر فقط پنج درصد مشتریان ریزش کنند، مدلی که همیشه «نمیرود» پیشبینی کند، دقت نود و پنج درصدی دارد اما هیچ ارزشی ندارد.
- نادیده گرفتن مدل پایه: بدون مقایسه با یک مدل ساده، معلوم نیست مدل پیچیده واقعاً چیزی اضافه کرده است یا نه.
- بیتوجهی به تغییر داده در طول زمان: رفتار مشتری، آبوهوا یا بازار تغییر میکند و مدلی که پایش نشود، بهتدریج فرسوده میشود.
- گزارش فنی برای مخاطب غیرفنی: اگر مدیر نتیجه را نفهمد، از آن استفاده نمیکند، هرچقدر هم مدل خوب باشد.
در ماژولهای دوره هر یک از این خطاها با یک نوتبوک نمونه بازسازی میشود تا شرکتکننده نشانههای آن را در پروژه خود تشخیص دهد و راه پیشگیری را تمرین کند.
مسیرهای شغلی پس از دوره یادگیری ماشین
مهارتهای این دوره با چند نقش رایج در بازار کار داده همخوان است:
| نقش شغلی | کار اصلی | ماژولهای کلیدی |
|---|---|---|
| تحلیلگر داده | تحلیل اکتشافی، مصورسازی و گزارش | ۱ تا ۳ |
| دانشمند داده مقدماتی | مدلسازی پیشبینی و ارزیابی | ۳ تا ۶ |
| مهندس یادگیری ماشین مقدماتی | خط لوله مدل و آمادهسازی برای استقرار | ۳، ۵ و ۸ |
| متخصص حوزهای دادهمحور | بهکارگیری مدل در کشاورزی، شهر یا کسبوکار | ۴ تا ۸ |
| پژوهشگر دادهمحور | مدلسازی در پایاننامه و مقاله | همه ماژولها |
مقایسه دوره یادگیری ماشین با مسیرهای دیگر یادگیری
برای یادگیری این حوزه چند مسیر وجود دارد. انتخاب به هدف و شرایط شما بستگی دارد:
| مسیر | نقطه قوت | محدودیت |
|---|---|---|
| دورههای آنلاین بینالمللی | محتوای قوی و رایگان یا کمهزینه | نبود بازخورد روی پروژه و داده بومی |
| درس دانشگاهی | عمق نظری و ریاضی | فاصله با پروژه واقعی و ابزارهای روز |
| بوتکمپ فشرده | سرعت و تمرکز بر استخدام | فشار زمانی و پوشش کمتر مبانی آماری |
| دوره ترکیبی بینش جدید | پیوند آمار، کد، الگوریتم و کاربرد حوزهای با پروژه واقعی | نیاز به پایتون مقدماتی و تمرین منظم |
چکلیست خودارزیابی دوره یادگیری ماشین
این چکلیست را پیش از دوره و پس از آن پر کنید. هر موردی که امروز با «نه» پاسخ میدهید، یکی از اهداف یادگیری شماست:
- میتوانم یک مسئله واقعی را به طبقهبندی، رگرسیون یا خوشهبندی تبدیل کنم.
- با pandas داده را میخوانم، ادغام میکنم و پاکسازی میکنم.
- میدانم نشت داده چیست و چطور از آن جلوگیری کنم.
- تفاوت دقت، بازیابی و صحت را با یک مثال واقعی توضیح میدهم.
- اعتبارسنجی متقابل را بهدرستی اجرا میکنم.
- میتوانم توضیح دهم چرا مدل برای یک نمونه خاص چنین پیشبینیای کرده است.
- سوگیری احتمالی داده را پیش از مدلسازی بررسی میکنم.
- یک پروژه کامل یادگیری ماشین در نمونه کارهایم دارم.
شیوه برگزاری و ارزیابی
شیوه برگزاری، یعنی آنلاین یا حضوری بودن و زمان دقیق جلسات، هنگام اعلام دوره در تقویم آموزشی مشخص میشود. ارزیابی بر پایه تمرینهای کدنویسی و پروژه پایانی است. در طول مسیر از مدرس و همدورهایها بازخورد میگیرید.
سازمانها میتوانند دوره یادگیری ماشین را برای تیم داده یا فناوری خود با دادهها و مسئلههای همان سازمان بهصورت اختصاصی برگزار کنند.
دورههای مکمل دانش ترکیبی
دوره یادگیری ماشین با چند دوره و آموزش دیگر بینش جدید پیوند دارد. اگر با داده مکانی کار میکنید، دوره GIS ترکیبی مکمل ماژول کاربردهای شهری و کشاورزی است. کارشناسان منابع انسانی میتوانند تحلیل ترک خدمت را که در دوره مدیریت منابع انسانی هوشمند آموختهاند، با مدلهای این دوره پیشبینی کنند. بازاریابها هم بخشبندی مشتری را در کنار دوره دیجیتال مارکتینگ دادهمحور به کار میبرند. برای داده متنی فارسی، آموزش متنکاوی با پایتون و برای کاربرد در پژوهش، مقاله هوش مصنوعی در پژوهش را ببینید.
جمعبندی
یادگیری ماشین در عمل ترکیبی از چهار مهارت است: آمار که از نتیجهگیری اشتباه جلوگیری میکند، پایتون و مهندسی داده که ماده خام را آماده میکند، الگوریتمها که پیشبینی میکنند و دانش حوزهای و اخلاق که تعیین میکند مدل چه زمانی و چطور باید استفاده شود. دوره یادگیری ماشین بینش جدید این چهار مهارت را در هشت ماژول و یک پروژه کامل کنار هم میگذارد. اگر میخواهید از تحلیل توصیفی به مدلهایی برسید که به تصمیم واقعی کمک میکنند، این دوره نقطه شروع مناسبی است.
کتابهای پیشنهادی دوره یادگیری ماشین
این کتابها برای مطالعه تکمیلی پیشنهاد میشوند؛ منابع پروژه پایانی دوره یادگیری ماشین متناسب با موضوع هر شرکتکننده تعیین میشود.
پرسشهای متداول دربارهٔ دوره یادگیری ماشین
پاسخ پرسشهای پرتکرار درباره دوره یادگیری ماشین، از محتوا و مخاطبان تا شیوه برگزاری.
۱یادگیری ماشین چیست؟
یادگیری ماشین شاخهای از هوش مصنوعی است که در آن الگوها بهجای قاعدههای صریح از داده آموخته میشوند تا مدل بتواند درباره نمونههای جدید پیشبینی یا دستهبندی کند.
۲پیش نیاز یادگیری ماشین چیست؟
پایتون مقدماتی، ریاضیات دبیرستانی و آمار مقدماتی کافی است. مفاهیم جبر خطی، حسابان و احتمال مورد نیاز در خود دوره به زبان شهودی مرور میشوند.
۳آیا برای یادگیری ماشین ریاضیات پیشرفته لازم است؟
برای شروع و بیشتر کاربردهای عملی خیر. فهم شهودی مفاهیمی مثل تابع هزینه، گرادیان و احتمال کافی است. برای پژوهش در الگوریتمهای جدید، ریاضیات عمیقتر لازم میشود.
۴این دوره یادگیری ماشین با پایتون است؟
بله. همه تمرینها و پروژه پایانی با پایتون و کتابخانههای pandas، scikit-learn و ابزارهای متنباز دیگر انجام میشود.
۵بهترین دوره یادگیری ماشین چه ویژگیهایی دارد؟
دوره خوب آمار و شهود را کنار کد آموزش میدهد، با داده نامرتب واقعی کار میکند، ارزیابی و تفسیر مدل را جدی میگیرد و شرکتکننده را به یک پروژه کامل با بازخورد میرساند.
۶این دوره برای چه کسانی مناسب است؟
برای تحلیلگران داده، برنامهنویسان، پژوهشگران و دانشجویان تحصیلات تکمیلی، متخصصان حوزهای، مدیران محصول و کسانی که میخواهند وارد حوزه علم داده شوند.
۷این دوره آنلاین است یا حضوری؟
شیوه برگزاری و زمان جلسات هنگام اعلام دوره در تقویم آموزشی مشخص میشود. اگر شیوه خاصی برایتان مهم است، آن را در فرم ثبتنام بنویسید.
۸آیا امکان برگزاری اختصاصی برای سازمان وجود دارد؟
بله. دوره را میتوان برای تیم داده یا فناوری سازمان با دادهها و مسئلههای همان سازمان بهصورت اختصاصی برگزار کرد.
ثبتنام در دوره یادگیری ماشین ترکیبی
اگر میخواهید از تحلیل توصیفی به مدلهایی برسید که به تصمیم واقعی کمک میکنند و چرخه کامل یک پروژه داده را خودتان اجرا کنید، به این دوره ویژه دانش ترکیبی بپیوندید.
- هشت ماژول از آمار و پایتون تا تفسیرپذیری و اخلاق
- ترکیب آمار، مهندسی داده، الگوریتمها و کاربرد حوزهای
- پروژه پایانی کامل با بازخورد مدرس و همدورهایها
- امکان برگزاری اختصاصی برای تیم داده یا فناوری سازمان
برای ثبتنام یا اطلاع از زمان برگزاری، فرم زیر را پر کنید. نوع درخواست را «ثبتنام در دوره یا ورکشاپ» انتخاب کنید و در فیلد موضوع بنویسید «دوره یادگیری ماشین». همکاران ما بهمحض قطعی شدن زمان برگزاری با شما تماس میگیرند.