هوش مصنوعی در پژوهش در مدت کوتاهی از یک موضوع آیندهنگرانه به بخشی از کار روزمرهی دانشجویان، استادان و پژوهشگران سازمانی تبدیل شده است. از جستوجوی منابع و خلاصه کردن مقالات تا تحلیل داده و ویرایش متن، ابزارهای هوشمند در تقریباً هر مرحلهی پژوهش حضور دارند. اما همین حضور گسترده، پرسشهای جدی هم به همراه آورده است: کجا استفاده از هوش مصنوعی مجاز و مفید است؟ کجا به اعتبار علمی آسیب میزند؟ و پژوهشگر چگونه میتواند از این ابزارها استفاده کند بدون آنکه کنترل فکری کار را از دست بدهد؟
در این مقاله کاربردهای هوش مصنوعی را در چرخهی کامل پژوهش مرور میکنیم، ریسکها و ملاحظات اخلاقی را توضیح میدهیم و یک چارچوب عملی برای استفادهی مسئولانه ارائه میکنیم.
فهرست مطالب
- چرخهی پژوهش و جایگاه هوش مصنوعی در آن
- کاربردهای اصلی هوش مصنوعی در پژوهش
- ریسکها و ملاحظات اخلاقی
- چارچوب عملی: پنج قاعده برای استفادهی مسئولانه
- سطحبندی ریسک کاربردهای هوش مصنوعی در پژوهش
- پروتکل راستیآزمایی منابع و ادعاها
- الگوهای پرامپت برای پژوهشگران
- متن نمونهی افشای استفاده از هوش مصنوعی
- حریم خصوصی و دادههای حساس پژوهشی
- مقایسهی رویکردها: پژوهشگر سنتی، پژوهشگر وابسته و پژوهشگر ترکیبی
- نقش هوش مصنوعی در انواع پژوهش
- کاربرد هوش مصنوعی در پژوهشهای حوزههای تخصصی
- جمعبندی
- پرسشهای متداول
چرخهی پژوهش و جایگاه هوش مصنوعی در آن
هر پژوهش، از پایاننامهی کارشناسی ارشد تا پروژهی تحقیق و توسعه در یک شرکت، کمابیش این مراحل را طی میکند: انتخاب مسئله، مرور ادبیات، طراحی روش، جمعآوری داده، تحلیل، نگارش و انتشار. هوش مصنوعی در هر مرحله نقش متفاوتی دارد و میزان ریسک هم در هر مرحله فرق میکند.
| مرحله | کمک هوش مصنوعی | سطح ریسک | نکتهی کلیدی |
|---|---|---|---|
| انتخاب مسئله | طوفان فکری، یافتن زاویههای تازه | کم | ایدهها را با ادبیات واقعی بسنجید |
| مرور ادبیات | جستوجوی معنایی، خلاصهسازی مقالات | متوسط تا زیاد | خطر منابع جعلی؛ هر ارجاع را چک کنید |
| طراحی روش | پیشنهاد طرح پژوهش، نقد طرح | متوسط | تصمیم روششناختی با پژوهشگر است |
| جمعآوری داده | طراحی پیشنویس پرسشنامه، پیادهسازی مصاحبه | متوسط | محرمانگی دادهی مشارکتکنندگان |
| تحلیل | نوشتن کد، کدگذاری اولیهی کیفی | متوسط | نتایج را مستقل بازتولید کنید |
| نگارش | ویرایش زبانی، ساختاردهی | متوسط تا زیاد | سرقت علمی و سیاستهای افشا |
کاربردهای اصلی هوش مصنوعی در پژوهش
۱. یافتن و انتخاب مسئله
یکی از دشوارترین بخشهای پژوهش، رسیدن به یک پرسش خوب است. مدلهای زبانی میتوانند در گفتوگو، زاویههای مختلف یک موضوع را پیشنهاد دهند، پرسشهای شما را به چالش بکشند یا ارتباط موضوع شما را با حوزههای دیگر نشان دهند. این کاربرد کمریسک است، به شرط آنکه پیشنهادها را فقط بهعنوان نقطهی شروع ببینید و با مرور ادبیات واقعی بسنجید.
۲. مرور ادبیات
ابزارهای جستوجوی معنایی میتوانند مقالات مرتبط را حتی وقتی کلیدواژهها دقیق نیستند پیدا کنند، و مدلهای زبانی میتوانند چکیدهی مقالات را خلاصه کنند. اما اینجا بزرگترین خطر هم وجود دارد: مدلهای زبانی عمومی گاهی منابعی میسازند که وجود خارجی ندارند یا محتوای مقالهای را نادرست نقل میکنند. قاعدهی طلایی ساده است: هیچ منبعی را که خودتان باز نکرده و نخواندهاید، ارجاع ندهید.
۳. طراحی روش و ابزار
هوش مصنوعی میتواند پیشنویس پرسشنامه تهیه کند، گویههای مبهم را شناسایی کند یا طرحهای پژوهشی مختلف را مقایسه کند. برای مثال، اگر بین طرحهای روش تحقیق آمیخته مردد هستید، میتوانید از یک مدل زبانی بخواهید مزایا و معایب هر طرح را برای پرسش شما فهرست کند. اما انتخاب نهایی باید بر اساس منابع روششناسی معتبر و مشورت با استاد راهنما یا همکاران باشد.
۴. تحلیل داده
شاید ملموسترین اثر هوش مصنوعی در تحلیل داده باشد. پژوهشگرانی که برنامهنویسی بلد نیستند، میتوانند با کمک دستیارهای هوشمند کدهای تحلیل آماری را در پایتون یا R بنویسند و توضیح هر خط را بخواهند. این کار یادگیری را سریعتر میکند، اما خطر هم دارد: کدی که نمیفهمید ممکن است تحلیل اشتباهی انجام دهد. راه درست، یادگیری مبانی است؛ مقالهی تحلیل داده و اتوماسیون با پایتون و دورهی علم داده برای علوم انسانی و اجتماعی برای همین هدف طراحی شدهاند.
در پژوهش کیفی، ابزارهای هوش مصنوعی میتوانند در پیادهسازی مصاحبهها و پیشنهاد کدهای اولیه کمک کنند. اما تفسیر، که قلب پژوهش کیفی است، همچنان کاری انسانی است.
۵. نگارش و ویرایش
ویرایش زبانی، پیشنهاد ساختار فصلها، روانتر کردن جملات و ترجمهی پیشنویس از کاربردهای رایج است. ما در مقالهی گردش کار نگارش علمی با هوش مصنوعی یک روش گامبهگام برای این مرحله ارائه کردهایم. نکتهی اصلی این است که ایدهها، استدلالها و یافتهها باید از آنِ پژوهشگر باشند و ابزار فقط در بیان آنها کمک کند.
ریسکها و ملاحظات اخلاقی
نهادهای علمی و بینالمللی، از جمله یونسکو در راهنمای هوش مصنوعی مولد در آموزش و پژوهش، بر چند اصل مشترک تأکید دارند. مهمترین ریسکها برای پژوهشگر عبارتاند از:
- توهم و اطلاعات نادرست: تولید داده، نقلقول یا منبعی که وجود ندارد.
- سرقت علمی و مالکیت فکری: استفاده از متن تولیدشده بدون افشا، یا بازتولید ناخواستهی متن دیگران.
- محرمانگی داده: واردکردن دادههای مشارکتکنندگان، بهویژه دادههای حساس، در ابزارهای عمومی.
- سوگیری: مدلها بر دادههایی آموزش دیدهاند که ممکن است دیدگاهها و زبانهای خاصی را بیشتر بازنمایی کنند؛ این برای پژوهشهای فارسیزبان و بومی اهمیت ویژه دارد.
- کاهش مهارت پژوهشی: اگر همهی مراحل فکری به ابزار سپرده شود، پژوهشگر مهارت اصلی خود را از دست میدهد.
- عدم شفافیت: پنهان کردن استفاده از هوش مصنوعی، در حالی که بسیاری از مجلات و دانشگاهها افشای آن را الزامی میدانند.
چارچوب عملی: پنج قاعده برای استفادهی مسئولانه
- قاعدهی مالکیت فکری: پرسش، استدلال، تفسیر و نتیجهگیری باید از آنِ شما باشد. ابزار دستیار است، نه نویسنده.
- قاعدهی راستیآزمایی: هر ادعا، عدد و منبعی که از ابزار میگیرید را با منبع اصلی چک کنید.
- قاعدهی حفاظت از داده: دادهی شخصی و محرمانه را بدون تمهیدات لازم و رضایت مشارکتکنندگان وارد ابزارهای عمومی نکنید.
- قاعدهی شفافیت: سیاست دانشگاه یا مجلهی مقصد را بخوانید و استفاده از هوش مصنوعی را طبق آن افشا کنید.
- قاعدهی بازتولیدپذیری: پرامپتها، نسخهی ابزار و مراحل استفاده را یادداشت کنید تا کار شما قابل بازبینی باشد.
هوش مصنوعی در پژوهش سازمانی و تحقیق و توسعه
پژوهش فقط در دانشگاه انجام نمیشود. سازمانها هم برای شناخت مشتری، ارزیابی برنامهها، عارضهیابی و توسعهی محصول پژوهش میکنند. در این فضا، هوش مصنوعی میتواند سرعت را بالا ببرد: تحلیل سریع بازخورد مشتریان، خلاصهی گزارشهای صنعتی، پایش روندها و آزمون سریع فرضیهها. اگر با مفهوم پژوهش سازمانی آشنا نیستید، مقالهی تحقیق و توسعه چیست را بخوانید.
اما در پژوهش سازمانی هم همان قواعد برقرار است. تصمیمهای مهم کسبوکاری نباید بر اساس خلاصهای گرفته شوند که هیچکس منبع آن را بررسی نکرده است.
مهارتهایی که پژوهشگر امروز نیاز دارد
- سواد هوش مصنوعی: فهم اینکه مدلهای زبانی چگونه کار میکنند و چرا خطا میکنند. مقالهی هوش مصنوعی مولد چیست مقدمهی خوبی است.
- مهارت پرامپتنویسی: پرسیدن دقیق، دادن زمینه و درخواست استدلال؛ راهنمای مهندسی پرامپت را ببینید.
- سواد داده و آمار: برای ارزیابی خروجی تحلیلها.
- تفکر انتقادی: مهمترین مهارت؛ پرسیدن «از کجا میدانیم؟» در برابر هر خروجی.
- مدیریت دانش شخصی: سازماندهی منابع، یادداشتها و ایدهها؛ مقالهی مدیریت دانش شخصی در این زمینه کمک میکند.
یک گردش کار نمونه برای پایاننامه
برای اینکه این اصول ملموس شوند، یک گردش کار ساده برای دانشجوی کارشناسی ارشد که دربارهی «پذیرش فناوری در مدارس» پژوهش میکند:
- با یک مدل زبانی دربارهی زاویههای مختلف موضوع گفتوگو میکند و سه پرسش اولیه مینویسد.
- در پایگاههای علمی معتبر جستوجو میکند و مقالات اصلی را خودش میخواند؛ از ابزار فقط برای خلاصهی اولیهی مقالاتی استفاده میکند که متن کاملشان را دارد.
- پیشنویس پرسشنامه را با کمک ابزار تهیه میکند و سپس با استاد راهنما و یک مطالعهی مقدماتی اصلاح میکند.
- دادهها را بدون اطلاعات هویتی آماده میکند و برای نوشتن کد تحلیل از دستیار کمک میگیرد، اما هر خروجی را با محاسبهی مستقل چک میکند.
- متن پایاننامه را خودش مینویسد و برای ویرایش زبانی از ابزار استفاده میکند؛ نحوهی استفاده را در بخش روششناسی توضیح میدهد.
ابزار مناسب برای هر کار
بهجای اتکا به یک ابزار برای همهی کارها، بهتر است برای هر مرحله ابزار مناسب آن را انتخاب کنید. برای جستوجوی منابع، پایگاههای علمی معتبر و موتورهای جستوجوی تخصصی مقالات همچنان نقطهی شروع اصلیاند. مدلهای زبانی عمومی برای طوفان فکری، توضیح مفاهیم و ویرایش مفیدند. برای تحلیل آماری، محیطهایی مانند پایتون و R که خروجی قابل بازتولید میدهند بر ابزارهای جعبهسیاه ترجیح دارند. برای تحلیل کیفی هم نرمافزارهای تخصصی کدگذاری که امکان ردیابی کدها تا متن اصلی را میدهند، اطمینان بیشتری ایجاد میکنند.
سطحبندی ریسک کاربردهای هوش مصنوعی در پژوهش
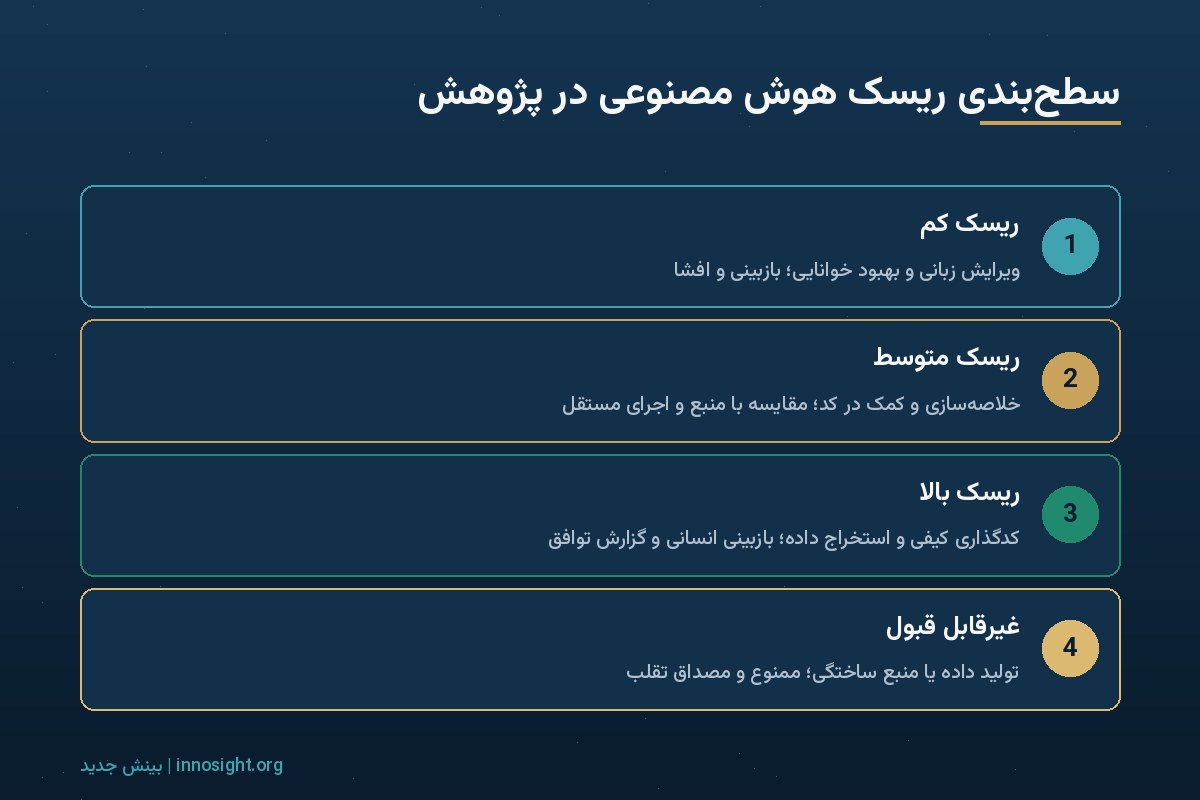
همهی کاربردهای هوش مصنوعی در پژوهش ریسک یکسانی ندارند. ویرایش زبانی یک پاراگراف با تولید بخشی از یافتهها از اساس متفاوت است. یک راه ساده برای تصمیمگیری، سطحبندی کاربردها بر اساس میزان اثرشان بر محتوای علمی و دشواری راستیآزمایی آنهاست.
| سطح ریسک | نمونهی کاربرد | الزام پیشنهادی |
|---|---|---|
| کم | ویرایش زبانی، بهبود خوانایی، ترجمهی پیشنویس برای فهم شخصی | بازبینی متن نهایی و افشا طبق قواعد مجله یا دانشگاه |
| متوسط | خلاصهسازی مقالهها، پیشنهاد ساختار، کمک در نوشتن کد تحلیل | مقایسه با منبع اصلی، اجرای مستقل کد و ثبت روش در بخش روششناسی |
| بالا | کدگذاری دادهی کیفی، استخراج داده از مقالهها برای مرور نظاممند | بازبینی انسانی کامل یا نمونهای، گزارش میزان توافق و افشای کامل |
| غیرقابل قبول | تولید داده یا نتیجه، ساختن منبع، نوشتن کامل بخشهای علمی بدون مشارکت واقعی پژوهشگر | ممنوع؛ مصداق تقلب یا سرقت علمی |
این جدول یک راهنمای کلی است. قواعد دانشگاه، مجله یا نهاد تأمینکنندهی بودجه همیشه مقدم است. بسیاری از ناشران بزرگ سیاستهای روشنی منتشر کردهاند؛ برای نمونه سیاست ویراستاری Nature دربارهی هوش مصنوعی تصریح میکند که ابزارهای مدل زبانی نمیتوانند نویسندهی مقاله شناخته شوند و استفاده از آنها باید در بخش روشها گزارش شود.
پروتکل راستیآزمایی منابع و ادعاها
یکی از جدیترین خطرهای هوش مصنوعی مولد در پژوهش، تولید منابع ساختگی است: ارجاعی با نام نویسنده، عنوان و مجلهای که کاملاً واقعی به نظر میرسد اما وجود ندارد. حتی وقتی منبع واقعی است، ممکن است ادعایی که به آن نسبت داده شده در متن اصلی نباشد. پروتکل ششگامی زیر را برای هر منبعی که از طریق هوش مصنوعی پیدا کردهاید اجرا کنید.
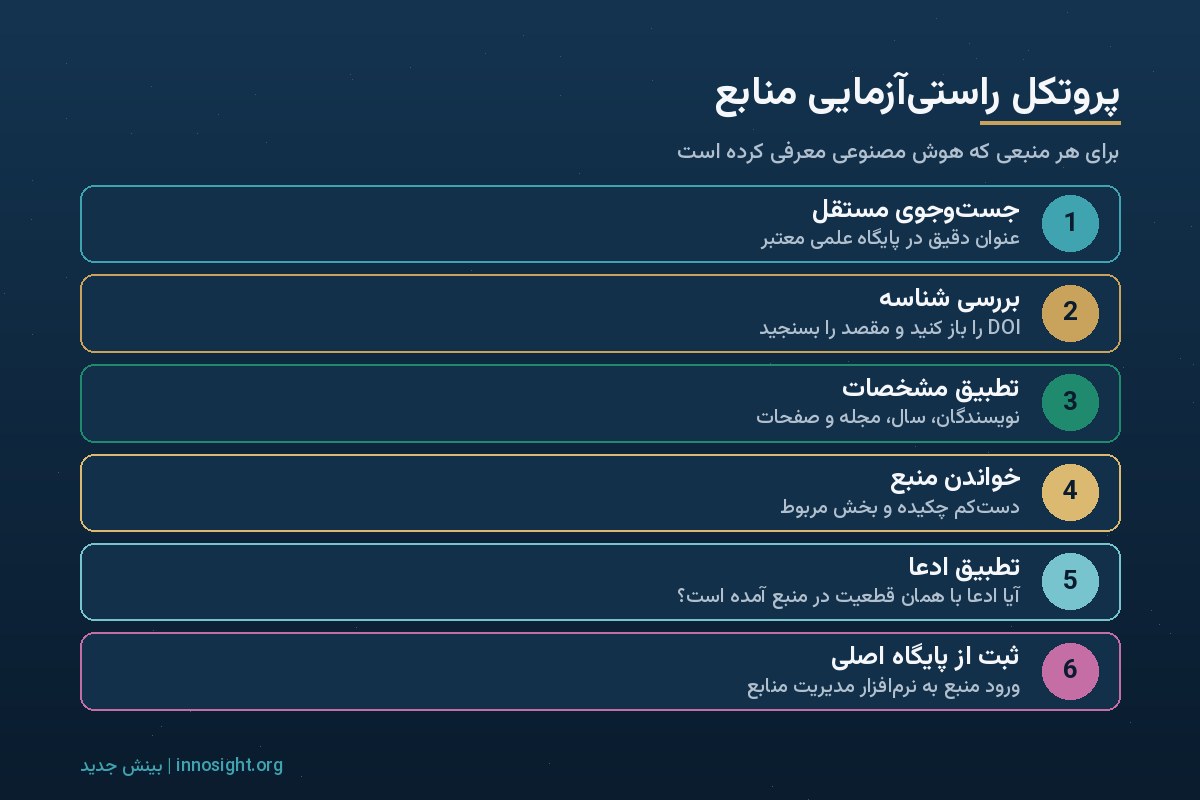
- جستوجوی مستقل: عنوان دقیق را در یک پایگاه علمی معتبر یا موتور جستوجوی علمی جستوجو کنید.
- بررسی شناسه: اگر DOI دارد، آن را باز کنید و مطمئن شوید به همان مقاله میرسد.
- تطبیق مشخصات: نویسندگان، سال، مجله، جلد و صفحات را با منبع اصلی مقایسه کنید.
- خواندن منبع: دستکم چکیده و بخش مربوط را بخوانید. اگر منبع کلیدی است، کل متن را.
- تطبیق ادعا: آیا ادعایی که میخواهید به منبع نسبت دهید، واقعاً در آن آمده است؟ با همان قطعیت؟
- ثبت در نرمافزار مدیریت منابع: منبع را از پایگاه اصلی وارد کنید، نه از متن تولیدشدهی هوش مصنوعی.
این پروتکل وقتگیر به نظر میرسد، اما بسیار کمهزینهتر از رد شدن مقاله یا آسیب به اعتبار علمی است. ابزارهایی که به پایگاههای علمی متصلاند و منبع واقعی را همراه پاسخ نشان میدهند، ریسک را کم میکنند اما از بین نمیبرند.
الگوهای پرامپت برای پژوهشگران
کیفیت خروجی هوش مصنوعی تا حد زیادی به کیفیت درخواست بستگی دارد. الگوهای زیر برای کارهای رایج پژوهشی طراحی شدهاند. آنها را با جزئیات پژوهش خود تکمیل کنید و همیشه خروجی را بازبینی کنید. اصول کلی نوشتن پرامپت را در راهنمای مهندسی پرامپت توضیح دادهایم.
الگوی دقیق کردن پرسش پژوهش
«من در حوزهی [رشته] دربارهی [موضوع] پژوهش میکنم. پرسش اولیهی من این است: [پرسش]. لطفاً سه نسخهی دقیقتر از این پرسش پیشنهاد بده که هر کدام جامعه، متغیرها یا پدیدهی اصلی را روشنتر کند. برای هر نسخه، نوع روش مناسب (کمی، کیفی یا آمیخته) و یک محدودیت احتمالی را بنویس.»
الگوی نقد طرح پژوهش
«نقش یک داور سختگیر را بازی کن. طرح پژوهش زیر را بخوان و پنج ضعف روششناختی احتمالی آن را بنویس. برای هر ضعف، یک پیشنهاد اصلاحی بده. [متن طرح بدون اطلاعات محرمانه]»
الگوی خلاصهی ساختاریافتهی مقاله
«متن زیر بخشی از یک مقاله است. آن را در قالب این بخشها خلاصه کن: پرسش پژوهش، روش، نمونه، یافتههای اصلی، محدودیتهایی که نویسندگان ذکر کردهاند. هر جا اطلاعاتی در متن نیست، بنویس “در متن نیامده” و چیزی اضافه نکن.»
الگوی توضیح کد تحلیل
«این کد پایتون برای تحلیل دادههای من نوشته شده است. خطبهخط توضیح بده چه میکند، فرضهای آماری آن را بنویس و بگو چه خطاهای احتمالی ممکن است در آن باشد.»
نکتهی مشترک همهی این الگوها این است که از هوش مصنوعی خواستهاند فکر شما را به چالش بکشد یا کار را ساختار دهد، نه اینکه بهجای شما فکر کند.
متن نمونهی افشای استفاده از هوش مصنوعی
شفافیت دربارهی استفاده از هوش مصنوعی، هم الزام اخلاقی است و هم در بسیاری از مجلات و دانشگاهها الزام رسمی. نمونهی زیر را میتوانید با شرایط پژوهش خود تطبیق دهید و در بخش روششناسی یا قدردانی قرار دهید:
نمونه: «در این پژوهش، از ابزار [نام ابزار و نسخه] برای [ویرایش زبانی پیشنویس فصلهای دوم و پنجم / پیشنهاد کدهای اولیه برای بخشی از دادههای کیفی / کمک در نوشتن کد تحلیل آماری] استفاده شده است. همهی خروجیها توسط نویسنده بازبینی، اصلاح و تأیید شدهاند و مسئولیت کامل محتوای علمی با نویسنده است. هیچ دادهی شخصی شناساییپذیری وارد این ابزار نشده است.»
حریم خصوصی و دادههای حساس پژوهشی
پژوهشگران اغلب با دادههایی کار میکنند که حساساند: متن مصاحبه با بیماران یا کارکنان، اطلاعات مالی سازمانها، دادههای آموزشی دانشآموزان یا اطلاعات مکانی خانوارها. وارد کردن چنین دادههایی در ابزارهای عمومی هوش مصنوعی میتواند تعهدات اخلاقی و قانونی پژوهشگر را نقض کند. چند قاعدهی پایه:
- پیش از هر استفاده، فرم رضایت آگاهانه و مصوبهی کمیتهی اخلاق را بررسی کنید. آیا اجازهی پردازش داده با ابزارهای بیرونی داده شده است؟
- دادهها را پیش از ورود به ابزار ناشناس کنید: نامها، مکانها، شمارهها و هر جزئیاتی که فرد را شناساییپذیر میکند، حذف یا جایگزین شود.
- شرایط استفادهی ابزار را بخوانید: آیا دادهها برای آموزش مدل استفاده میشوند؟ کجا ذخیره میشوند؟
- در صورت امکان از نسخههای سازمانی یا ابزارهای قابل اجرا روی رایانهی خود استفاده کنید که داده را بیرون نمیفرستند.
- هر استفاده را ثبت کنید تا در صورت پرسش داوران یا کمیتهی اخلاق، پاسخ روشن داشته باشید.
مقایسهی رویکردها: پژوهشگر سنتی، پژوهشگر وابسته و پژوهشگر ترکیبی
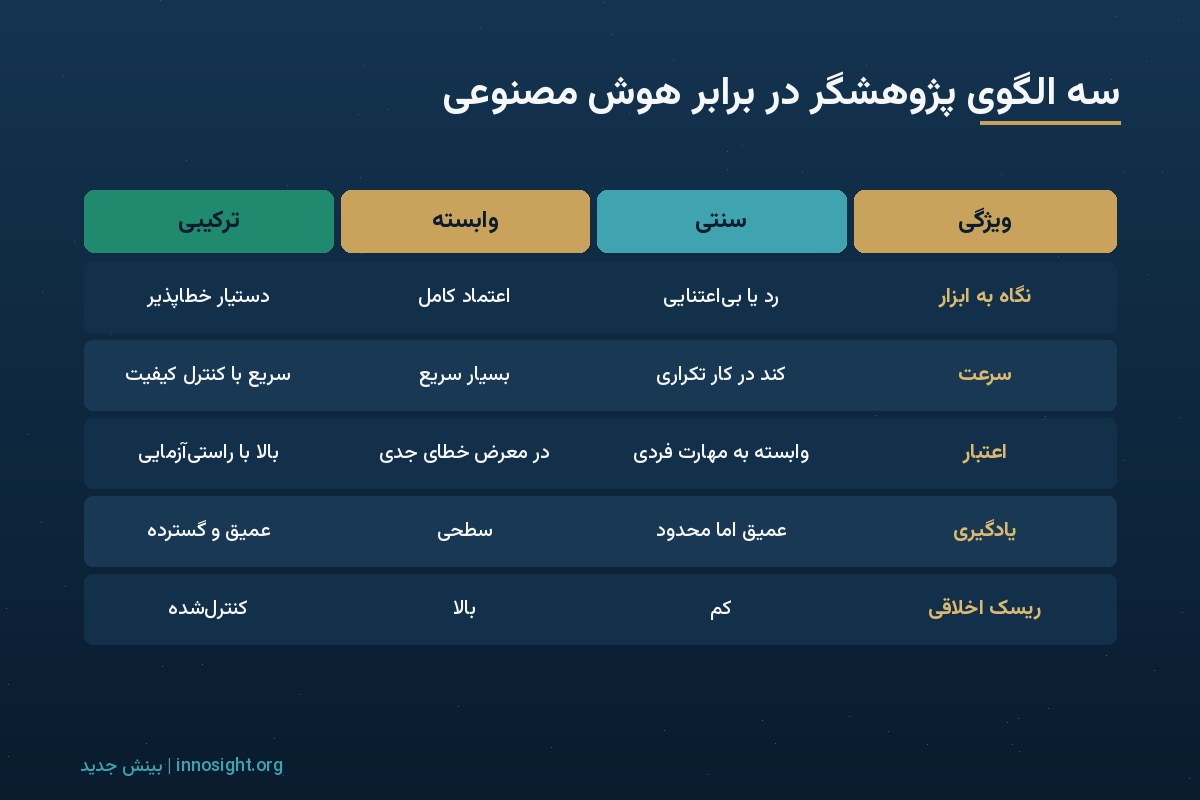
شاید مفید باشد سه الگوی رفتاری را در برابر هوش مصنوعی کنار هم ببینیم:
| ویژگی | پژوهشگر سنتی | پژوهشگر وابسته | پژوهشگر ترکیبی |
|---|---|---|---|
| نگاه به هوش مصنوعی | رد کامل یا بیاعتنایی | اعتماد کامل | دستیار قدرتمند اما خطاپذیر |
| سرعت کار | کند در کارهای تکراری | بسیار سریع | سریع با کنترل کیفیت |
| کیفیت و اعتبار | وابسته به مهارت فردی | در معرض خطاهای جدی | بالا، به شرط راستیآزمایی |
| یادگیری | عمیق اما محدود به منابع در دسترس | سطحی | عمیق و گسترده |
| ریسک اخلاقی | کم | بالا | کنترلشده |
هدف این مقاله کمک به شما برای قرار گرفتن در ستون سوم است: بهره بردن از سرعت و توان ابزارها بدون از دست دادن عمق، اعتبار و صداقت علمی.
برای پژوهشگران فارسیزبان یک نکتهی اضافه هم وجود دارد. بیشتر مدلهای زبانی با حجم بسیار بیشتری از متون انگلیسی آموزش دیدهاند و دانش آنها دربارهی پژوهشهای فارسی، نشریات داخلی و بافت اجتماعی و فرهنگی ایران محدودتر است. در نتیجه، احتمال خطا در معرفی منابع فارسی، اصطلاحات تخصصی و توصیف شرایط محلی بیشتر است. پژوهشگر ترکیبی این محدودیت را میشناسد: برای منابع فارسی مستقیماً به پایگاههای داخلی مراجعه میکند، معادلهای تخصصی را با منابع معتبر فارسی تطبیق میدهد و تفسیر بافت محلی را به دانش و تجربهی خود و شرکتکنندگان میسپارد.
در نهایت، معیار سادهای برای سنجیدن رویکرد خود دارید: اگر فردا همهی ابزارهای هوش مصنوعی از دسترس خارج شوند، آیا همچنان میتوانید از پژوهش خود دفاع کنید و هر بخش آن را توضیح دهید؟
نقش هوش مصنوعی در انواع پژوهش
پژوهش کمی
در پژوهش کمی، هوش مصنوعی بیشتر در پاکسازی داده، نوشتن و توضیح کد تحلیل، پیشنهاد آزمونهای آماری و تفسیر خروجیها کمک میکند. خطر اصلی، اجرای تحلیلهایی است که پژوهشگر منطق آن را نمیفهمد. قاعدهی ساده: هر تحلیلی که نمیتوانید برای داور توضیح دهید، در گزارش نیاورید.
پژوهش کیفی
در پژوهش کیفی، ابزارها میتوانند در پیادهسازی مصاحبهها، پیشنهاد کدهای اولیه و یافتن الگوها کمک کنند. اما تفسیر معنا، توجه به بافت فرهنگی و حساسیت به صدای شرکتکنندگان، کاری عمیقاً انسانی است. بسیاری از روششناسان کیفی هشدار میدهند که کدگذاری خودکار ممکن است لایههای ظریف معنا را نادیده بگیرد.
پژوهش آمیخته
در پژوهش آمیخته، هوش مصنوعی هم در بخش کمی و هم در بخش کیفی و هم در تلفیق آنها میتواند کمک کند. جزئیات این کاربردها را در مقالهی روش تحقیق آمیخته آوردهایم.
پژوهش کاربردی و سازمانی
در پژوهشهای سازمانی، سرعت اهمیت زیادی دارد و هوش مصنوعی میتواند زمان تهیهی گزارشهای پژوهشی را کوتاه کند. اما محرمانگی دادههای سازمان و دقت توصیهها اهمیت بیشتری دارد. مدیرانی که پژوهش را سفارش میدهند، باید بدانند گزارش با چه روشی و با چه میزان استفاده از هوش مصنوعی تهیه شده است؛ موضوعی که در مقالهی هوش مصنوعی برای مدیران هم به آن پرداختهایم.
کاربرد هوش مصنوعی در پژوهشهای حوزههای تخصصی
- کشاورزی و محیط زیست: تحلیل تصاویر ماهوارهای، پیشبینی عملکرد و پایش خشکسالی؛ در مقالهی هوش مصنوعی در کشاورزی بیشتر بخوانید.
- مطالعات شهری: تحلیل دادههای حملونقل، دسترسی به خدمات و الگوهای رشد شهری؛ مقالهی هوش مصنوعی در مدیریت شهری را ببینید.
- مدیریت و منابع انسانی: تحلیل متن نظرسنجیهای کارکنان و پژوهش دربارهی اثر ابزارهای هوشمند بر کار؛ مرتبط با مقالهی هوش مصنوعی در منابع انسانی.
- علوم انسانی: تحلیل متون بزرگ، مطالعات زبانی و تاریخی. دورهی علم داده برای علوم انسانی برای پژوهشگران این حوزه طراحی شده است.
تدوین سیاست هوش مصنوعی برای یک گروه یا مرکز پژوهشی
اگر سرپرست یک گروه پژوهشی، مدیر یک مرکز تحقیق و توسعه یا استاد راهنمای چند دانشجو هستید، داشتن یک سیاست مکتوب و کوتاه دربارهی استفاده از هوش مصنوعی، بسیاری از ابهامها و تعارضها را پیش از وقوع حل میکند. این سیاست لازم نیست طولانی باشد؛ یک یا دو صفحه کافی است، به شرط آنکه به پرسشهای کلیدی پاسخ دهد.
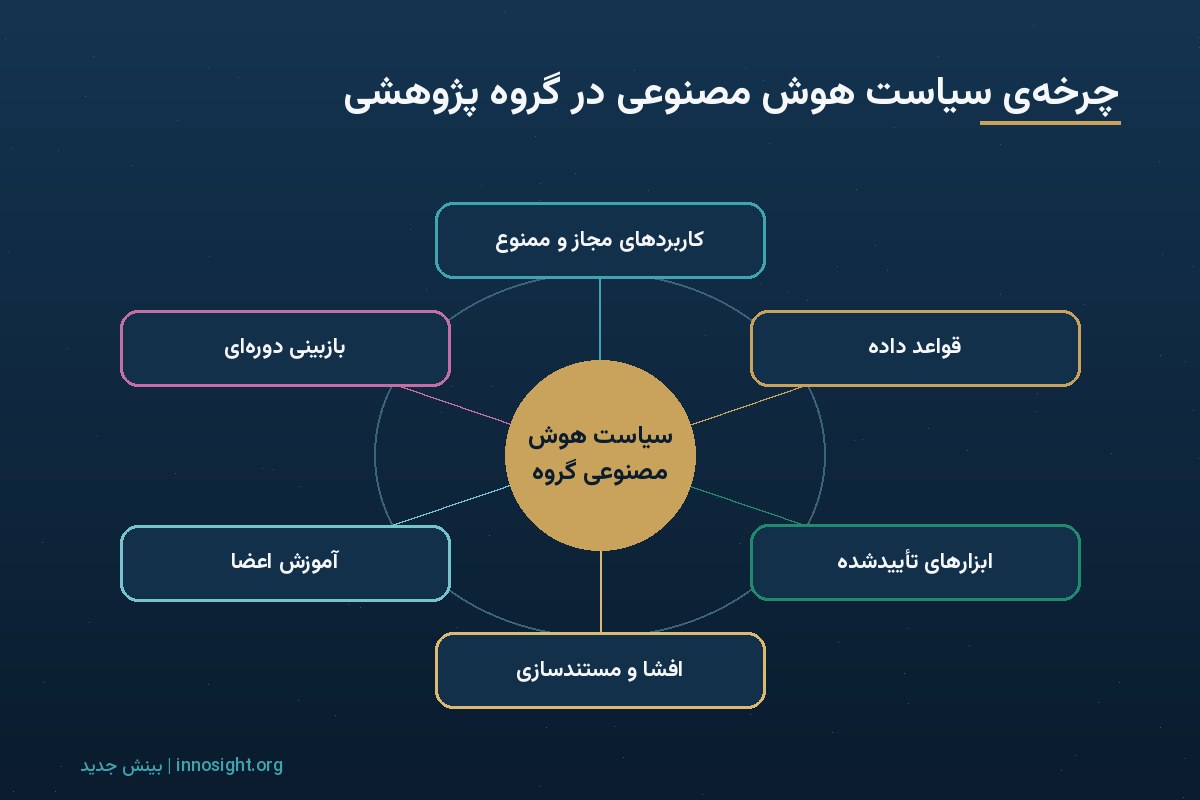
- کاربردهای مجاز و ممنوع: با تکیه بر سطحبندی ریسک این مقاله، مشخص کنید کدام کاربردها آزاد، کدام مشروط و کدام ممنوعاند.
- قواعد داده: چه دادههایی هرگز نباید وارد ابزارهای عمومی شوند و ناشناسسازی چگونه انجام میشود.
- ابزارهای تأییدشده: فهرست ابزارهایی که گروه بررسی کرده و شرایط استفادهی آنها را پذیرفته است.
- افشا و مستندسازی: هر عضو چگونه استفادهی خود را ثبت و در خروجیها افشا میکند.
- آموزش: هر عضو جدید پیش از استفاده، یک جلسهی کوتاه دربارهی این سیاست و پروتکل راستیآزمایی میگذراند.
- بازبینی دورهای: سیاست هر چند ماه یک بار با توجه به تجربهی اعضا و تغییر قواعد ناشران بهروز میشود.
چنین سیاستی برای مراکز تحقیق و توسعهی سازمانی هم ضروری است؛ جایی که علاوه بر صداقت علمی، محرمانگی دانش فنی و مالکیت فکری هم مطرح است. خدمات تحقیق و توسعهی بینش جدید و مشاورهی پروژههای پژوهشی میتوانند در طراحی این چارچوبها همراه شما باشند.
پژوهشگران مدیر: هوش مصنوعی در رسالههای DBA
مدیرانی که در دورههای DBA پژوهش میکنند، معمولاً وقت محدودی دارند و وسوسهی استفادهی گسترده از هوش مصنوعی برایشان بیشتر است. همین گروه اما بیشترین نفع را از استفادهی درست میبرند: ابزارها میتوانند فاصلهی آنها را با مهارتهای پژوهشی که سالها از آن دور بودهاند کم کنند، به شرط آنکه برای یادگیری به کار روند، نه جایگزینی. اگر در حال تصمیمگیری برای ورود به این مسیر هستید، مقالهی تفاوت DBA و MBA را بخوانید. توصیهی ما به این گروه ساده است: از هوش مصنوعی بخواهید شما را به چالش بکشد، روشها را توضیح دهد و پیشنویسهایتان را نقد کند؛ اما نوشتن استدلال، تفسیر داده و تصمیمهای روششناختی را خودتان انجام دهید.
اشتباهات رایج پژوهشگران در استفاده از هوش مصنوعی
- ارجاع به منبعی که خوانده نشده: حتی اگر منبع واقعی باشد، ادعای نسبتدادهشده ممکن است در آن نباشد.
- کپی مستقیم متن تولیدشده: علاوه بر مسائل اخلاقی، متن تولیدشده اغلب کلی، تکراری و فاقد صدای علمی پژوهشگر است.
- ورود دادهی خام شرکتکنندگان به ابزارهای عمومی: نقض محرمانگی و تعهدات اخلاقی.
- پنهان کردن استفاده: عدم افشا، حتی برای کاربردهای کمریسک، ممکن است بعداً به اعتبار پژوهشگر آسیب بزند.
- واگذاری تفسیر: تفسیر یافتهها قلب پژوهش است و مسئولیت آن با پژوهشگر است.
- نادیده گرفتن سوگیری مدلها: مدلها ممکن است دیدگاههای غالب در منابع انگلیسیزبان را بازتولید کنند و بافت محلی را نادیده بگیرند.
اگر تنها یک توصیه از این مقاله به خاطر بسپارید، این باشد: هوش مصنوعی را دستیاری قدرتمند اما خطاپذیر بدانید که سرعت شما را بالا میبرد، اما مسئولیت علمی، صداقت و قضاوت نهایی همیشه با خود شماست. پژوهشگری که این مرز را حفظ کند، از این ابزارها بیشترین بهره را میبرد.
جمعبندی
هوش مصنوعی در پژوهش ابزاری قدرتمند برای سرعت بخشیدن به کارهای وقتگیر است: جستوجو، خلاصهسازی، کدنویسی تحلیل و ویرایش. اما اعتبار پژوهش همچنان به قضاوت، صداقت و دقت پژوهشگر وابسته است. با رعایت قواعد مالکیت فکری، راستیآزمایی، حفاظت از داده، شفافیت و بازتولیدپذیری، میتوانید از این ابزارها بیشترین بهره را ببرید بدون آنکه کیفیت علمی کارتان آسیب ببیند.
اگر برای طراحی یا اجرای یک پروژهی پژوهشی، چه دانشگاهی و چه سازمانی، به همراهی تخصصی نیاز دارید، از مشاورهی پروژههای پژوهشی بینش جدید استفاده کنید.
پرسشهای متداول
آیا استفاده از هوش مصنوعی در نوشتن پایاننامه مجاز است؟
بستگی به سیاست دانشگاه و استاد راهنما دارد. بهطور کلی استفاده برای ویرایش و کمک فنی پذیرفتهتر است، اما تولید محتوای علمی توسط ابزار بدون افشا، در بیشتر نهادها تخلف محسوب میشود. پیش از استفاده، سیاستهای محل تحصیل خود را بررسی کنید.
چطور بفهمم منبعی که هوش مصنوعی معرفی کرده واقعی است؟
عنوان و نویسندگان را در پایگاههای علمی معتبر جستوجو کنید، متن اصلی را باز کنید و مطمئن شوید محتوای نقلشده واقعاً در آن آمده است. اگر منبع پیدا نشد، از آن استفاده نکنید.
آیا هوش مصنوعی میتواند جایگزین تحلیلگر آماری شود؟
میتواند در نوشتن کد و توضیح روشها کمک کند، اما انتخاب آزمون درست، بررسی پیشفرضها و تفسیر نتایج نیازمند دانش آماری است. خروجی را همیشه با درک خودتان یا مشورت متخصص بسنجید.
برای پژوهشهای فارسیزبان چه نکتهی خاصی وجود دارد؟
کیفیت ابزارها در فارسی، بهویژه برای اصطلاحات تخصصی و گفتار محاوره، ممکن است پایینتر از انگلیسی باشد. پیادهسازی مصاحبهها و ترجمهها را با دقت بیشتری بازبینی کنید.
آیا مجلات علمی مقالههایی را که با کمک هوش مصنوعی نوشته شدهاند، میپذیرند؟
بسیاری از مجلات استفاده از هوش مصنوعی را برای کارهایی مثل ویرایش زبانی میپذیرند، به شرط افشای شفاف. اما تقریباً همهی ناشران معتبر تأکید میکنند که ابزار هوش مصنوعی نمیتواند نویسندهی مقاله باشد و مسئولیت محتوا با نویسندگان انسانی است. پیش از ارسال، سیاست مجلهی هدف را بخوانید.
ابزارهای تشخیص متن هوش مصنوعی چقدر قابل اعتمادند؟
این ابزارها خطای قابل توجهی دارند و ممکن است متن انسانی را به اشتباه تولیدشده تشخیص دهند یا برعکس. به همین دلیل بهترین راهکار برای پژوهشگر، شفافیت و نگه داشتن سوابق کار (پیشنویسها، یادداشتها و نسخهها) است، نه نگرانی از ابزارهای تشخیص.
چگونه از هوش مصنوعی برای مرور نظاممند استفاده کنیم؟
هوش مصنوعی میتواند در غربالگری اولیهی عنوانها و چکیدهها و استخراج داده کمک کند، اما برای حفظ کیفیت باید دستکم بخشی از تصمیمها بهصورت مستقل توسط پژوهشگر بازبینی شود و میزان توافق گزارش شود. روش کار باید بهطور کامل در مقاله شرح داده شود.
آیا استفاده از هوش مصنوعی برای ترجمهی مقالههای انگلیسی مجاز است؟
برای فهم شخصی منابع، بله و بسیار مفید است. اما اگر میخواهید از متن ترجمهشده نقلقول کنید یا بر اساس آن ادعای علمی مطرح کنید، بخش مربوط را با متن اصلی مقایسه کنید؛ ترجمهی ماشینی ممکن است اصطلاحات تخصصی را نادرست برگرداند.
دیدگاهتان را بنویسید